新闻数据处理:从非结构化文本到因子矩阵
在处理金融新闻数据(如 WorldQuant Brain 竞赛中的 Alpha 挖掘)时,核心挑战在于如何将碎片化的新闻 Chunks(段落)转化为具有预测能力的“日期-实体”评分矩阵。
一、 标准处理管线 (Standard Pipeline)
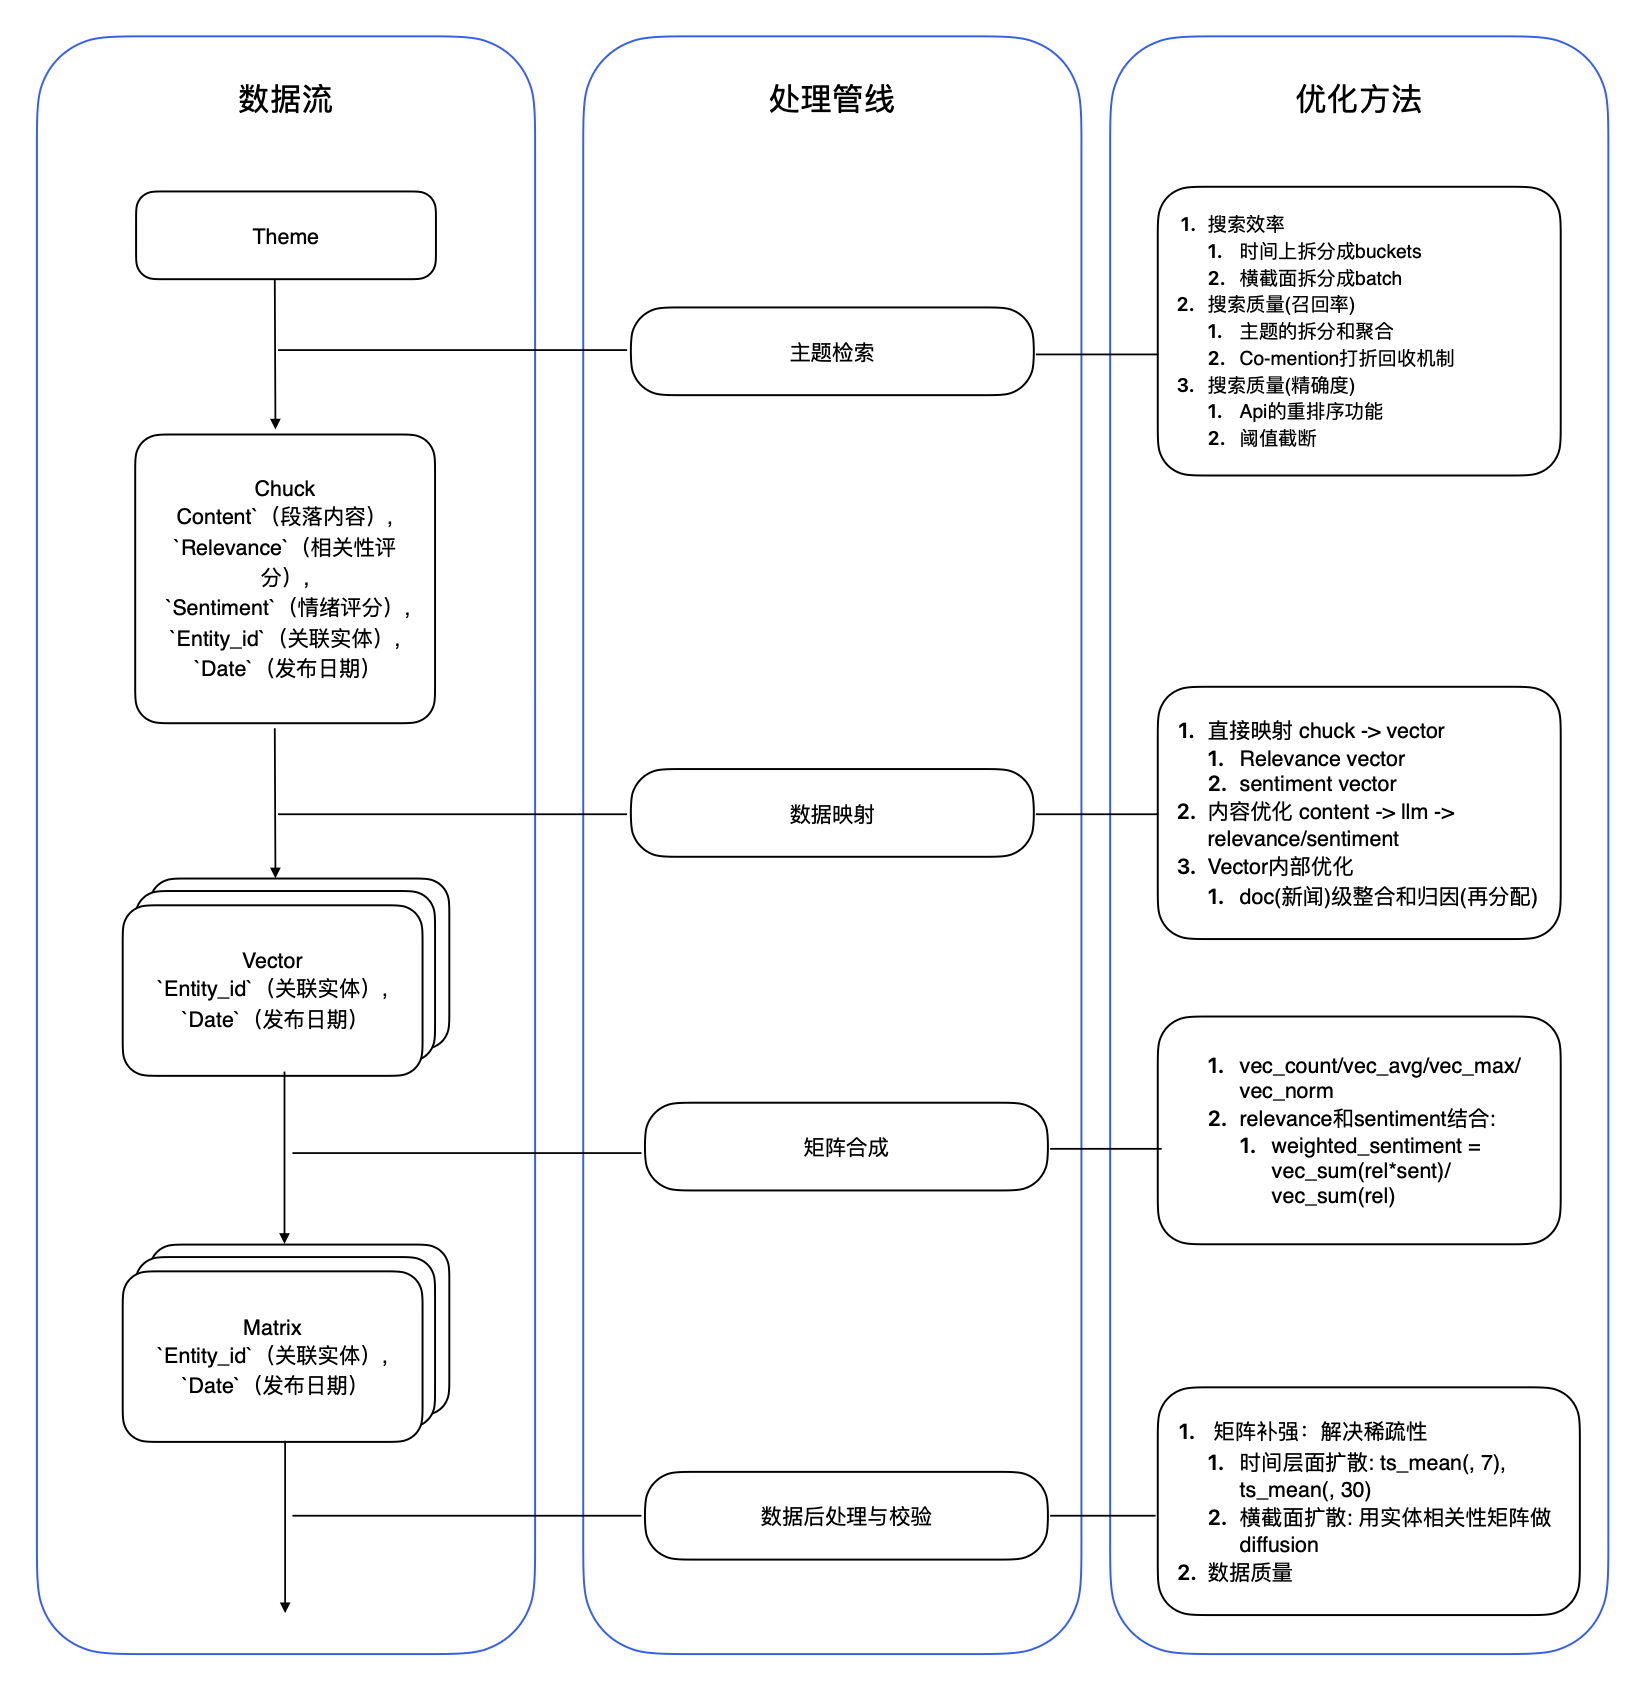
- 主题检索 (Retrieval):根据预设的主题(Themes)进行数据拉取。
- 数据映射与矩阵合成 (Mapping & Synthesis):
- 核心数据结构:API 返回的每一条原始数据均为一个 Chunk,包含核心字段:
Content(段落内容),Relevance(相关性评分),Sentiment(情绪评分),Entity_id(关联实体),Date(发布日期)。 - 物理映射:将每个 Chunk 的评分根据其
Date和Entity_id直接填充到对应的矩阵坐标中,形成横轴为 Entity、纵轴为 Date 的原始特征矩阵。
- 核心数据结构:API 返回的每一条原始数据均为一个 Chunk,包含核心字段:
- 数据校验 (Validation):在进入 Alpha 研究前,对矩阵的覆盖率(Coverage)、空值率(NaN Ratio)以及极端值分布进行工程化检查。
二、 关键优化策略 (Optimization Strategies)
1. 搜索效率:Smart-batching
- 痛点:全量检索容易触发 API 单次 1,000 Chunks 的截断限制或请求超时。
- 基础拆分逻辑 (Baseline):
- 时间分段:按月划分 Buckets,例如将 2 年的追溯期拆分为 24 个 Buckets。
- 实体分批:按每组 500 个实体 划分 Batch,针对 3,000 个实体的 Universe 拆分为 6 个 Batches。
- Smart-batching 进阶优化:不再均匀切割,而是根据新闻集中度动态调整:
- 时间维优化:利用 Volume API 监控主题热度。对于新闻爆发的“热点日期”,自动缩减 Bucket 跨度(如从月缩短至天),防止数据截断。
- 实体维优化:利用 Co-mention API 预估实体热度。对于高覆盖率实体缩小 Batch 规模,实现资源的“错峰检索”。
- 注:Volume 与 Co-mention API 可能会触发 ‘query too complex’ 错误,工程上需避免同时高频调用。
2. 深度召回:主题树拆解与剪枝 (Theme Decomposition)
- 分而治之:针对叶子节点(Sub-themes)分别进行精准检索,提升垂直领域的召回率(Recall)。
- 路径聚合:沿着树形路径将子主题信号向上归并,并对数据量不足的节点进行“剪枝”处理,确保最终进入矩阵的信号具备统计显著性。
3. 打折回收:Direct vs Co-mention
- 痛点:api会返回部分不在搜索batch中的chucks。
- 优化:建立差异化权重逻辑。
- Direct (1.0x):实体为检索目标。
- Co-mention (0.5x):实体在文中出现, 文中不存在检索目标(陪跑实体)。
4. vec内部:doc(新闻)级整合和归因(再分配)
- 痛点:简单平均 Sentiment 会导致“背景废话”段落稀释核心段落情绪,使评分趋向中性。
- 优化:采用 Relevance 加权算法。
doc_ws= $\sum(Sentiment \times Relevance) / \sum(Relevance)$- 该算法能让模型更关注高度相关的段落(核心事实),忽略低相关的噪声段落。
5. llm根据chunk内容优化relavance和sentiment vector:
- 相关性判别:输出 is_theme_related (0/1),剔除仅有关键词重合但逻辑无关的“伪阳性”段落。
- Impact 转换:将通用 Sentiment 转化为针对目标公司的 Business Impact:
- Positive $\rightarrow$ +1(如:供应短缺导致的议价能力提升)
- Negative $\rightarrow$ -1(如:停产危机)
- Neutral/Unclear $\rightarrow$ 0
6. 矩阵补强:解决稀疏性
- 时序平滑:利用 ts_mean(7/30) 捕获新闻情绪的“滞后性吸收”与“持续性影响”,解决新闻数据的离散性问题。
- 截面扩散 (Cross-sectional Diffusion):利用实体间的 Co-mention数量 制作关系矩阵,将热点实体的信号沿关系链向关联实体扩散填补,利用“网络效应”缓解原始矩阵的稀疏性。
其他优化策略
利用数据集中其他信号
- Novelty Weighting: 对同一实体、同一天的所有 Chunks 计算 Embedding 相似度。如果两条信息高度相似(相似度 > 0.9),则对后出现的信号进行衰减系数(如 0.2x)处理.
- confidence-Weighted Synthesis: 让llm打分时额外输出置信度用于加权
- 利用
source_rank信息区分主流财经媒体(如路透、彭博)与地方性小报 - 信号制作:
- 采取不同的时间衰减策略
- 用log(volume) 给sentiment加权
RAG 治理与幻觉控制
这是个搜索/分析问题, 和最近流行的RAG比较相似, 我们可以尝试用RAG治理的方法论优化流程
- 已经在流程里实现的:
- Query Decomposition / Multi-Query:
- Post-Retrieval Reranking: Cross-Encoder, api已经提供rerank功能
- Faithfulness & Citations:
- 实体掩码 (De-biasing):通过
[TARGET_COMPANY]占位符技术,切断模型对特定公司的先验偏见,强迫其仅根据文中事实进行推理 - 归因溯源 (Citations):强制 LLM 输出 Motivation
- 实体掩码 (De-biasing):通过
- 可以尝试优化/进一步实施的:
- HyDE (Hypothetical Document Embeddings): 先让 LLM 生成一段“虚构的理想新闻片段”,再用这个片段去向量空间检索. 提高召回率
- Small-to-Big 检索 (Parent Document Retrieval): 喂给 LLM 重新打分时,提供该 Chunk所在的整段窗口(Window)或整篇文章
- RAG-Fusion / Collective Reasoning: 同一天同一entity的chucks 拼接喂给 LLM 重新打分