- content 141
- shader 7
- photoshop 6
- sensor 6
- ComfyUI 5
- attention 5
- python 5
- shortcut 5
- homology 4
- llm 4
- render 4
- sdxl 4
- simulation 4
- stable-diffusion 4
- tauri 4
- 3-manifold 3
- alpha 3
- controlnet 3
- filter 3
- fundamental_group 3
- geometry_node 3
- ipadapter 3
- jekyll 3
- multi-spectrum 3
- optical_flow 3
- physics 3
- pi 3
- AI 2
- Alpha 2
- Optimization 2
- async 2
- blender 2
- canny 2
- cohomology 2
- data_structure 2
- dsl 2
- euler_character 2
- homotopy 2
- hyperbolic_geometry 2
- isp 2
- knot 2
- macOS 2
- macos 2
- opencv 2
- persistent_homology 2
- raycast 2
- rmux 2
- sampling 2
- script 2
- stock 2
- tangent_vector_field 2
- test 2
- utm 2
- vue 2
- worldquant 2
- 日用品 2
- 粒子系统 2
- 3d_model 1
- 3d_rotation 1
- BSDF 1
- Cech_complex 1
- DDPM 1
- EMVA1288 1
- GA 1
- Gauss_Bonnet 1
- Gemini 1
- Greedy 1
- L1_norm 1
- Lagrange_multiplier 1
- Lefschetz_number 1
- Mamba 1
- Markov_chain 1
- Markowitz_model 1
- Mongodb 1
- PROSAC 1
- Playwright 1
- Portfolio 1
- RAG 1
- Riemann_metric 1
- SMLD 1
- SSM 1
- Search 1
- Seifert_surface 1
- Tessellation 1
- Trichotomy 1
- acid 1
- adaboost 1
- ast 1
- atlas 1
- barcode 1
- basic 1
- betti_number 1
- block 1
- build 1
- camera 1
- camera_raw 1
- chain 1
- characteristic_class 1
- claude_code 1
- color 1
- combo 1
- contrastive_learning 1
- cover 1
- curve 1
- data 1
- dataset 1
- de_Rham_cohomology 1
- debugging 1
- deck_transformation 1
- deeplearning 1
- degree_of_mapping 1
- design 1
- device 1
- differential_form 1
- diffusion 1
- discrete 1
- disinfectant 1
- dpm-solver 1
- dual_mesh 1
- duality 1
- equal_weight 1
- fiber_bundle 1
- filtration 1
- fix_point 1
- flash attention 1
- gaussian_map 1
- genus 1
- github 1
- github_actions 1
- gligen 1
- gpu 1
- graph 1
- grid_sample 1
- gui 1
- hair 1
- harmonic_energy 1
- harmonic_form 1
- harmonic_function 1
- harmonic_map 1
- hex 1
- hodge_star 1
- homeomorphic 1
- hp 1
- hugging_face 1
- idea 1
- image 1
- index 1
- inpaint 1
- isotopic 1
- kalman 1
- lcm 1
- leetcode 1
- life 1
- lift 1
- linear attention 1
- llama 1
- logo 1
- lora 1
- loss 1
- manifold 1
- markdown 1
- material 1
- mesh 1
- modifier 1
- music 1
- network 1
- news 1
- noise 1
- norm 1
- obsidian 1
- obstruction 1
- pair_graph 1
- parser 1
- pid 1
- pipeline 1
- point_cloud 1
- pratt 1
- proximal_operator 1
- pyside6 1
- pytorch 1
- quad-mesh 1
- qwen 1
- refine 1
- regularization 1
- rust 1
- sci-pop 1
- sde 1
- search 1
- sentiment 1
- shampoo 1
- simplex 1
- simplical_complex 1
- simplicial_cohomology 1
- solidify 1
- speedup 1
- standard 1
- state 1
- state space model 1
- stoke 1
- string 1
- tda 1
- ternary 1
- time series 1
- topological_data_analysis 1
- track 1
- triangulation 1
- typescript 1
- uni-pc 1
- universal_cover 1
- vector_field 1
- video_editor 1
- vscode 1
- zero_point 1
- 三角剖分 1
- 不动点定理 1
- 动漫 1
- 发旋定理 1
- 宠物安全 1
- 异步 1
- 微信 1
- 电场 1
- 胃病 1
- 蒸馏 1
- 表情包 1
- 醒图 1
content
Pi Desktop:从会话浏览器到跨机器工作台
我最初只是想给 pi coding agent 补一个桌面会话浏览器:按项目查看 JSONL、展开工具调用,需要时从原会话继续聊。
用AI agent复现我的博客风格
让 agent 代写博客,卡住我的不是内容,是风格。反复改了几版都不对味,最后把博客库全量统计了一遍,整理出可复用的风格特征,并用 subagent 迭代验证到收敛。这篇分四部分:风格素材库(可直接喂给 AI)、采样过程与迭代、写《AI 做微信表情包》的实战、subagent 迭代实践。
听课app开发调研
本报告致力于提供全球视频提取课件、自动识别、场景检测领域的全量级深度分析。涵盖了从顶层商业平台到基层开源算法的每一个技术细节,旨在为 LessonCap 的长远发展提供无可辩驳的决策依据。
mac电脑的奇怪问题
交换内存
本地模型尝试
记录一下在 Windows 环境下配置 llama.cpp 的全过程,包括编译、启动参数调优、网络排查以及接入开发工具链的细节。
LLM接口协议梳理
梳理一下主流 LLM 接口的请求/响应结构、调用模式,以及各协议的差异,方便选型和对接时快速对照。
时序上的参数优化和神经网络
问题: 对给出的固定字段和feature, 怎么连续的调参
- 特征:
- pv原始数据
- 已知有信号的现成特征
- loss:
- -sharpe
- 可以用的样本数很少. 66为周期的话, 5年的样本数只有 5x512/66=17 个
- 样本少其实就是约束少, 容易过拟合的意思
- 模型容量
- 可以用的样本数很少. 66为周期的话, 5年的样本数只有 5x512/66=17 个
- 把mu和sigma拆开成线性的
- -sharpe
- activation
- demean, L1
- 优化
- SGD普通
- Adam: 解决各个特征大小不均衡的问题
处理新闻数据
新闻数据处理:从非结构化文本到因子矩阵
用 Agent 对黑盒公式进行逆向工程
面对一组只有输入输出的多维黑盒数据,如果我们确信其背后存在一个由人类专家设计的简洁内部公式,应该如何将其精准还原?
马年主题
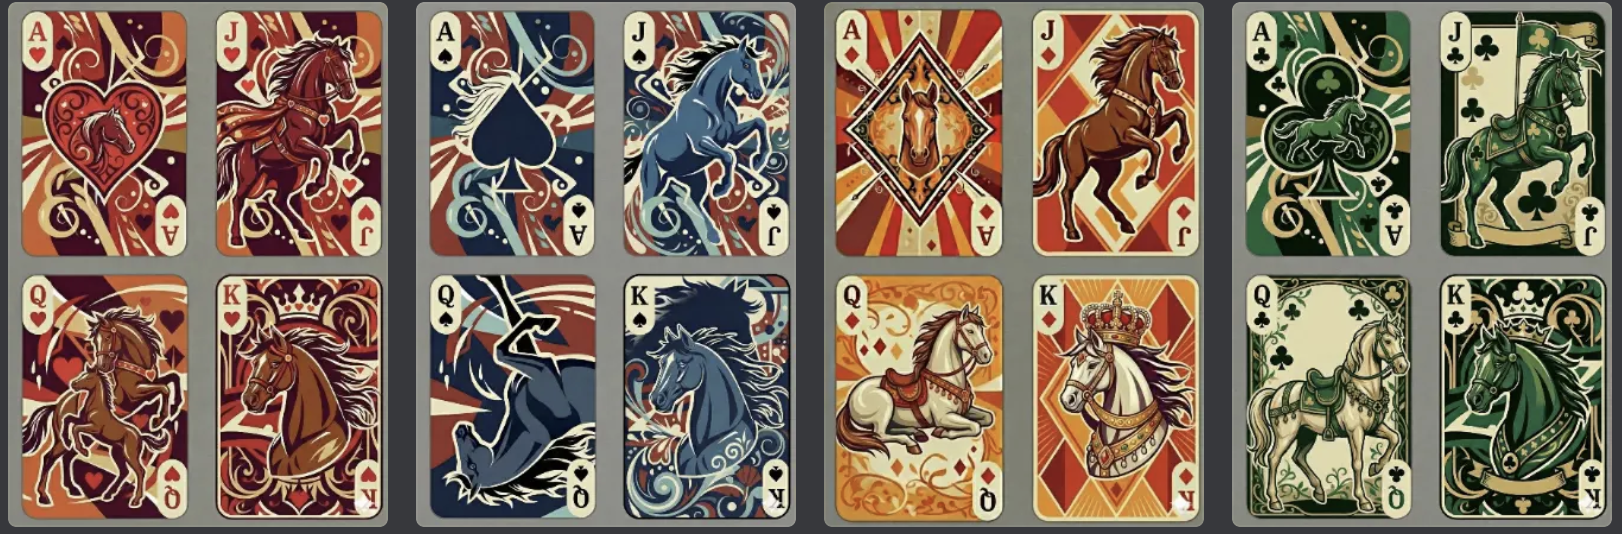
量子计算
Born Rule
抓包分析软件实际请求
看到request具体内容
怎么把一个小功能润色成用户产品
通过学习这个 优秀的案例 学了一些我没做到, 不过不知道有没有用的技巧. 应该有点用吧?
更专业的github
组合交易 (二)
单个alpha的性能
常用消毒液成分分类与安全性调研
核心成分与使用全图谱
代码模块的多维索引
记录讨论代码模块多维索引的发展
服务器发送消息通知
发送文字/表格/图片的混合消息
hash映射
估算alpha id 和什么有关
pv 衍生数据
pv数据
nano-banana 效果: 常用的作图功能
换背景(inpaint)
mac系统字典
目标是把 MongoDB 里存放的术语和定义,打包成可以在 macOS 自带“字典”应用中查询的本地词典。
代码语法解析
三元运算符(ternary)解析
洗衣机分类
- 洗衣机
给 VsCode 安装插件
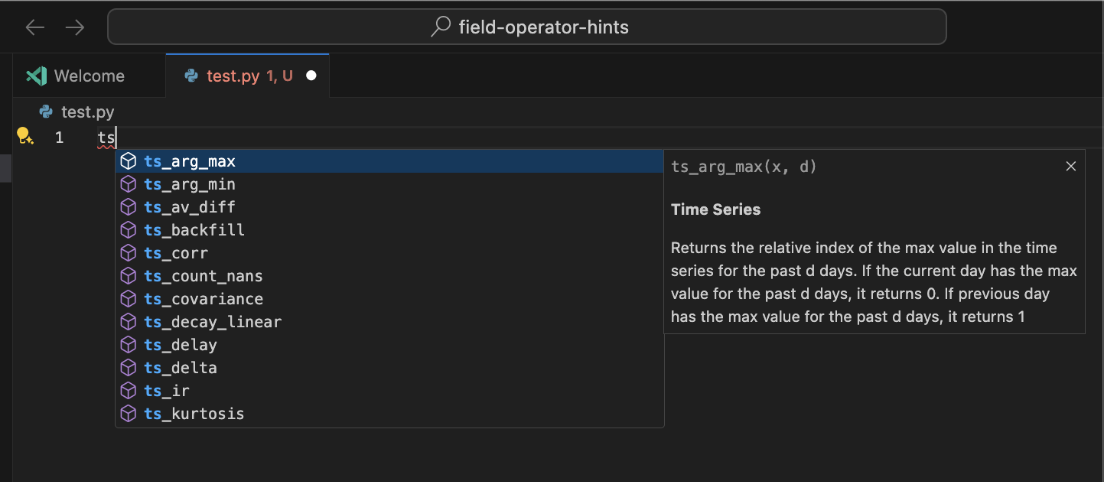
选出最佳的表达式组合
从给定的100个左右operator, 和10多个参数, 结合生成表达式
拉格朗日乘子法应用 (一 )
拉格朗日乘子法(Lagrange multiplier )一般问题
Tauri 项目 Build 与 Release 实践总结
本文记录了我在使用 Tauri 构建桌面端应用时遇到的一些坑和解决方案,包括配置文件管理、macOS 编译、GitHub Actions 自动构建等内容。
组合交易 (一)
单个alpha仿真交易流程
设置开机自启动自运行程序
macos
worldquant BRAIN 股票因子 (六 ) – 代码优化
我最终选择了使用 Tauri 来构建我的桌面回测应用。本文记录了开发过程中需求梳理、初始化步骤、遇到的坑以及一些性能优化技巧。
MCP协议理解
MCP(Model Context Protocol)
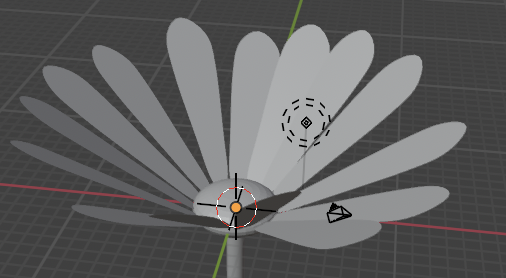
blender学习: 几何节点花瓣
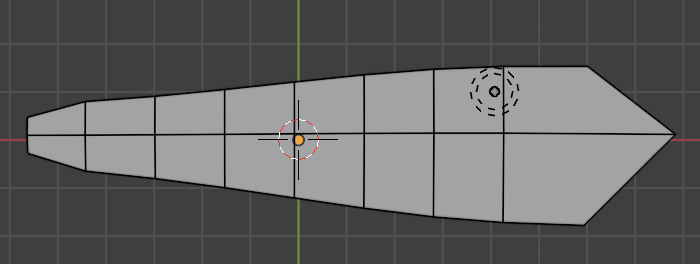 ->
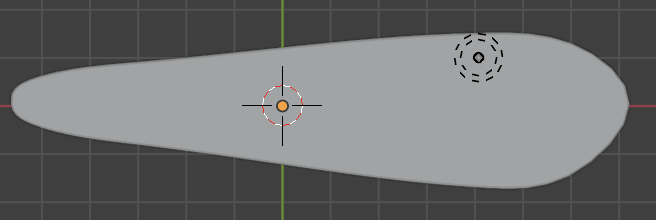 ->
聚类
距离
blender学习: 内发光效果
- 设置材质: 透明+自发光
- 用transparent shader和emmision shader合成
- 用layer weight node控制参数
- Frensnel 模式(对比度更高): 和frensel node一样公式, 把用IOR调节, 改成0-1调节weight
- Facing 模式: 按face面向镜头的角度调节weight
- 添加辉光: 用Compositing的glare node -> Fog Glow
筛选适合阅读的论文
| 搜索步骤 | 目的 | 输入->输出 |
|---|---|---|
| 一级搜索 | 按时间, 类别, 标题搜索文章 | 获取标题, 作者, 文章链接, summary |
| 二级搜索 | 判断summary是否对主题有用 | summary + prompt -> yes/no |
| 三级搜索 | 判断文章内容 |
worldquant BRAIN 股票因子 (五 ) – 数据集理解
| 数据集 | 特点 | 信号 |
|---|---|---|
| 模型数据集(model) | 大多是分数形式 | |
| 基本面数据 | 1. PE(市盈率) = eps/close2. PS(市销率) = close*sharesout/revenue3. cashflow/price 4. cashflow/sales 5. margin, pretax margin, operating margin 6. enterprise value 7. long term debt/operating income |
|
| 风险数据 | 1. 用risk factor做neutralize 2. 用risk-return 代替returns 3. |
|
| 量价数据 | 完整, 所有市场都有 | 1. 交易量激增(volume spike) 2. -returns |
| 社交媒体数据 | 更新频率高 有时效性: 尽量不要超过1季度 |
|
| 期权数据集(Options) | 1. IV_call, IV_put配对 | |
| 分析师数据 |
很多是vector数据 更新频率低 有很多异常值 |
1. 预测和当前值的差异 2. 预测值随时间变化 3. 分析师修订模型数据 |
| 宏观数据(Macro) | ||
| other数据 | 1. group分类数据 2. 用matrix 特征数据自己制作group |
|
| 期权数据 | 1. O/S volume ratio=期权未平仓量/volume |
blender学习: 制作随音乐律动的视频
传感器颜色调制 (四) – 多光谱颜色校准
用RGB校准多光谱数据
blender学习: 制作水体
用displacement+noise texture制作
切菜板成分
材质
worldquant BRAIN 股票因子 (四) – 因子思路
事件
worldquant BRAIN 股票因子 (三) – API使用和代码
仿真流程
协程的用法
协程就是单线程多任务, 在一个任务等待的时候干点别的其他的任务. 所以包含等待的函数都要用协程的版本: 在需要时交出event loop的控制权.
python 协程的用法
worldquant BRAIN 股票因子 (二) – 因子思路
一些因子的来源和原理
worldquant BRAIN 股票因子 (一) – 仿真测试
选择在模拟盘中表现好的因子投资
blender学习: 用几何节点做程序化城市
参考这个教学
雪花制作 ❄️
终端配置
zsh
3d模型资源, 数据库
3d模型文件格式
Serverless服务
租虚拟服务器代替真实服务器
blender学习: 五角星 ⭐️
参考这个教学
blender学习: 用Grease pencil 涂色
参考这个教学
🐍 蛇年圣诞风格海报
blender学习: 扭曲晶体路径跟随
参考这个教学
几种拍图技巧
荷花🪷
conformal geometry学习 (十一 ) – harmonic map
在复分析里被研究很多
平面调和函数性质
洗发水成分
成分分类
conformal geometry学习 (十一 ) – Hodge Star Operator
Hodge Star Operator
数学概念 – tensor( 张量 )
tensor是描述多种线性量的统一形式
iphone快捷指令
iphone和windows互相复制剪切板
小红书直播方法
- 用电脑端的小红书直播助手 指南
- 获取推流码
- 创作中心 -> 全部服务 -> 主播中心 -> 去开播, 选择pc, 得到6位数字验证码
- 在https://www.xiaohongshu.com/zhibo/obs 输入得到串联密钥
- 按照参数设置obs推流: 服务器地址, 分辨率, fps, 比特率等
- 获取推流码
猫幽门螺杆菌调查
一篇关于猫幽门螺杆菌的实验论文
驾照考试
科目一
attention的优化– KV Cache
conformal geometry学习 (十 ) – 举例: 球面上的unit tangent bundle manifold
atlas
金融衍生品
债券
raycast脚本
调整视频追踪物体
Final Cut Pro
- 教程
- 步骤:
- 添加原视频
- 在原视频上添加tracker, analysis跟踪物体的bbox
- 复制原视频一份
- 在复制视频的transformer应用之前的tracker, scale改成-100%
- tracker的坐标和画面的坐标位置相反?
- 把物体移到画面中间
- 放大scale去掉黑边
自制猫爬架
底座
摄像头测距
- 问题定义: 从摄像头组拍摄的画面中得到汽车的3维bounding box
给 Melvor Idle制作 Mod
制作
墙皮脱落问题
根据这个视频学习, 墙皮粉化, 剥落
掼蛋规则
两副扑克牌(54x2=108张, 对家是一队)
搬家相关准备
行李
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
猫罐头调查
金交的罐头上有很多黑色的地方
柳树怎么表现
在上海的春天到处去赏花, 感觉没有一种花有柳树的视觉冲击力. 嫩黄的叶子让我有生命的实感, 看到叶子泛白干燥的时候, 我知道春天过去了.
persistent homology 事例 + 应用
pair graph
conformal geometry学习 (八 ) – Persistent homology
一种计算 $H_k(\Sigma,\mathbb Z_2)$ 的方法, 计算filtration $\mathbb K$ 中homology的变化
conformal geometry学习 (七 ) – Duality, homology relation
conformal geometry学习 (六 ) – cohomology group
上同调是同调的对偶
conformal geometry学习 (五 ) – homology group
曲面的离散表示
conformal geometry学习 (四 ) – 3-manifold
3维流型, 在局部和$\mathbb R^3$ homeomorphic(同胚)
conformal geometry学习 (三 ) – Knot
Knot ($K: \mathbb S^1\rightarrow \mathbb R^3$ )
conformal geometry学习 (二 ) – Universal Covering
covering space
web3钱包
分类
conformal geometry学习 (一 ) – fundamental group
fundamental group分类曲面是足够精细的
报税计算
T-Display-S3开发版
开发方法
四边形网格生成
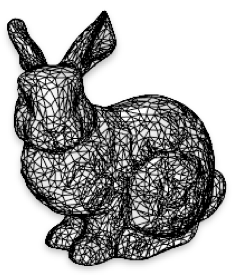 ->
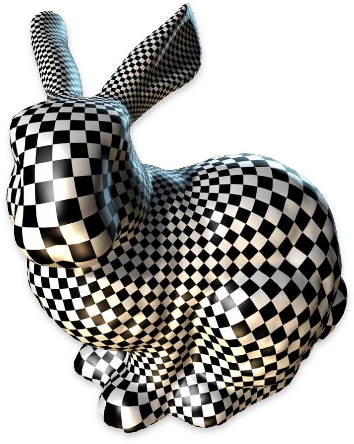
python工具
启动脚本
blender学习: 冰材质
在IOR=1.31的透明材质基础上, 添加表面的凹凸和内部的裂痕, 气泡
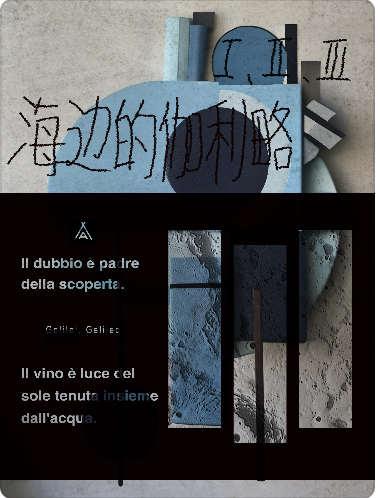
阿那亚戏剧节的海报制作
FFT计算
- fourier Series 定义:
- $F(f)(u)=\int_{-\infty}^{\infty} f(x)e^{-2\pi i x u} dx$
- 2维:$G(p,q)=F(g(x,y)) = \int\int^\infty_\infty g(x,y)e^{-i2\pi(px+qy)}dxdy$
- 2维的可以拆分成1维
- 离散形式: 信号$x$ 的FFT 信号$X$
- $X_k=\sum_{m=0}^{N-1}x_m\cdot e^{-i\cdot 2\pi km/N}=\sum_{m=0}^{N-1}x_m\cdot TW(N,k)^m$
- $N$ 是信号长度
- $k$ 是sample的位置
- $TW(N,k) = e^{-i*2k\pi/N}$ 是FFT 的twiddle factor(旋转因子)
- $TW(N,k)=\cos(-2k\pi/N)+i\cdot \sin(-2k\pi/N)=TW_r(N,k)+i\cdot TW_i(N,k)$
- $X_k=\sum_{m=0}^{N-1}x_m\cdot e^{-i\cdot 2\pi km/N}=\sum_{m=0}^{N-1}x_m\cdot TW(N,k)^m$
劳动仲裁流程和资料整理
材料
blender学习: 用布料系统做膨胀效果
参考这个教学
给网页添加 logo
各种 moving function
场景
moving mean
小面积光流传感器算法测试 (三) – 滤波
在高速场景下, 每次中断收集的数据是光流的累加值, 其实本来就相当于一个滤波…况且在硬件有限的条件下, 复杂的滤波没有什么实用价值.
小红书学到的几种图片调色 (二)
人物美白
小面积光流传感器算法测试 (二) – 特征训练
数据
stable-diffusion中 k-sampling的不同版本 (二 )
ComfyUI中的一些代码实现
stable-diffusion中 k-sampling的不同版本 (一 )
背景知识
Diffusion Process 和 Reverse Diffusion Process理解
背景知识
Bayes’ rule
小面积光流传感器算法测试 (一)
大概分为: preprocess -> instant flow compute -> filter correct 三个步骤
画一个环形的重复图样
blender学习: 几何节点做摄像头移动阵列
参考这个教学
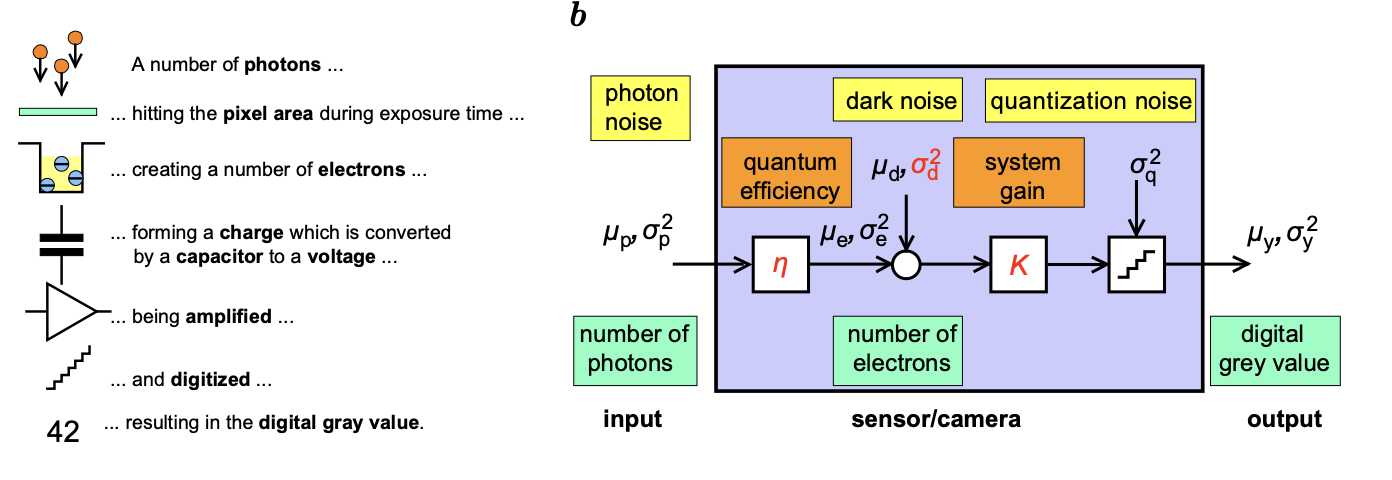
EMVA1288 sensor测试
pyside6一些功能的用法
pyside是qt的python封装, API的调用方法基本差不多. 用pyside从零开始写一个gui用于标注或测试(调参数或者看中间结果), 每次花费时间都比想象的要少的多. 功能方便而且代码的可读性非常好.
blender学习: 用粒子系统做毛毡效果
步骤:
attention的优化– flash attention加速
flash-attention是一种算子合并(kernel fusion)的优化. 把self-attention分块, 直接在SRAM里计算, 省去了HBM来回搬运中间结果S和P的时间(如下图). self-attention由两层矩阵乘法, softmax, 和其他eltwise计算(mask, dropout)构成.
blender学习: 镜头推移
前向推镜头
blender学习: 做流光效果
用金属材质反射world背景的流动
步骤:
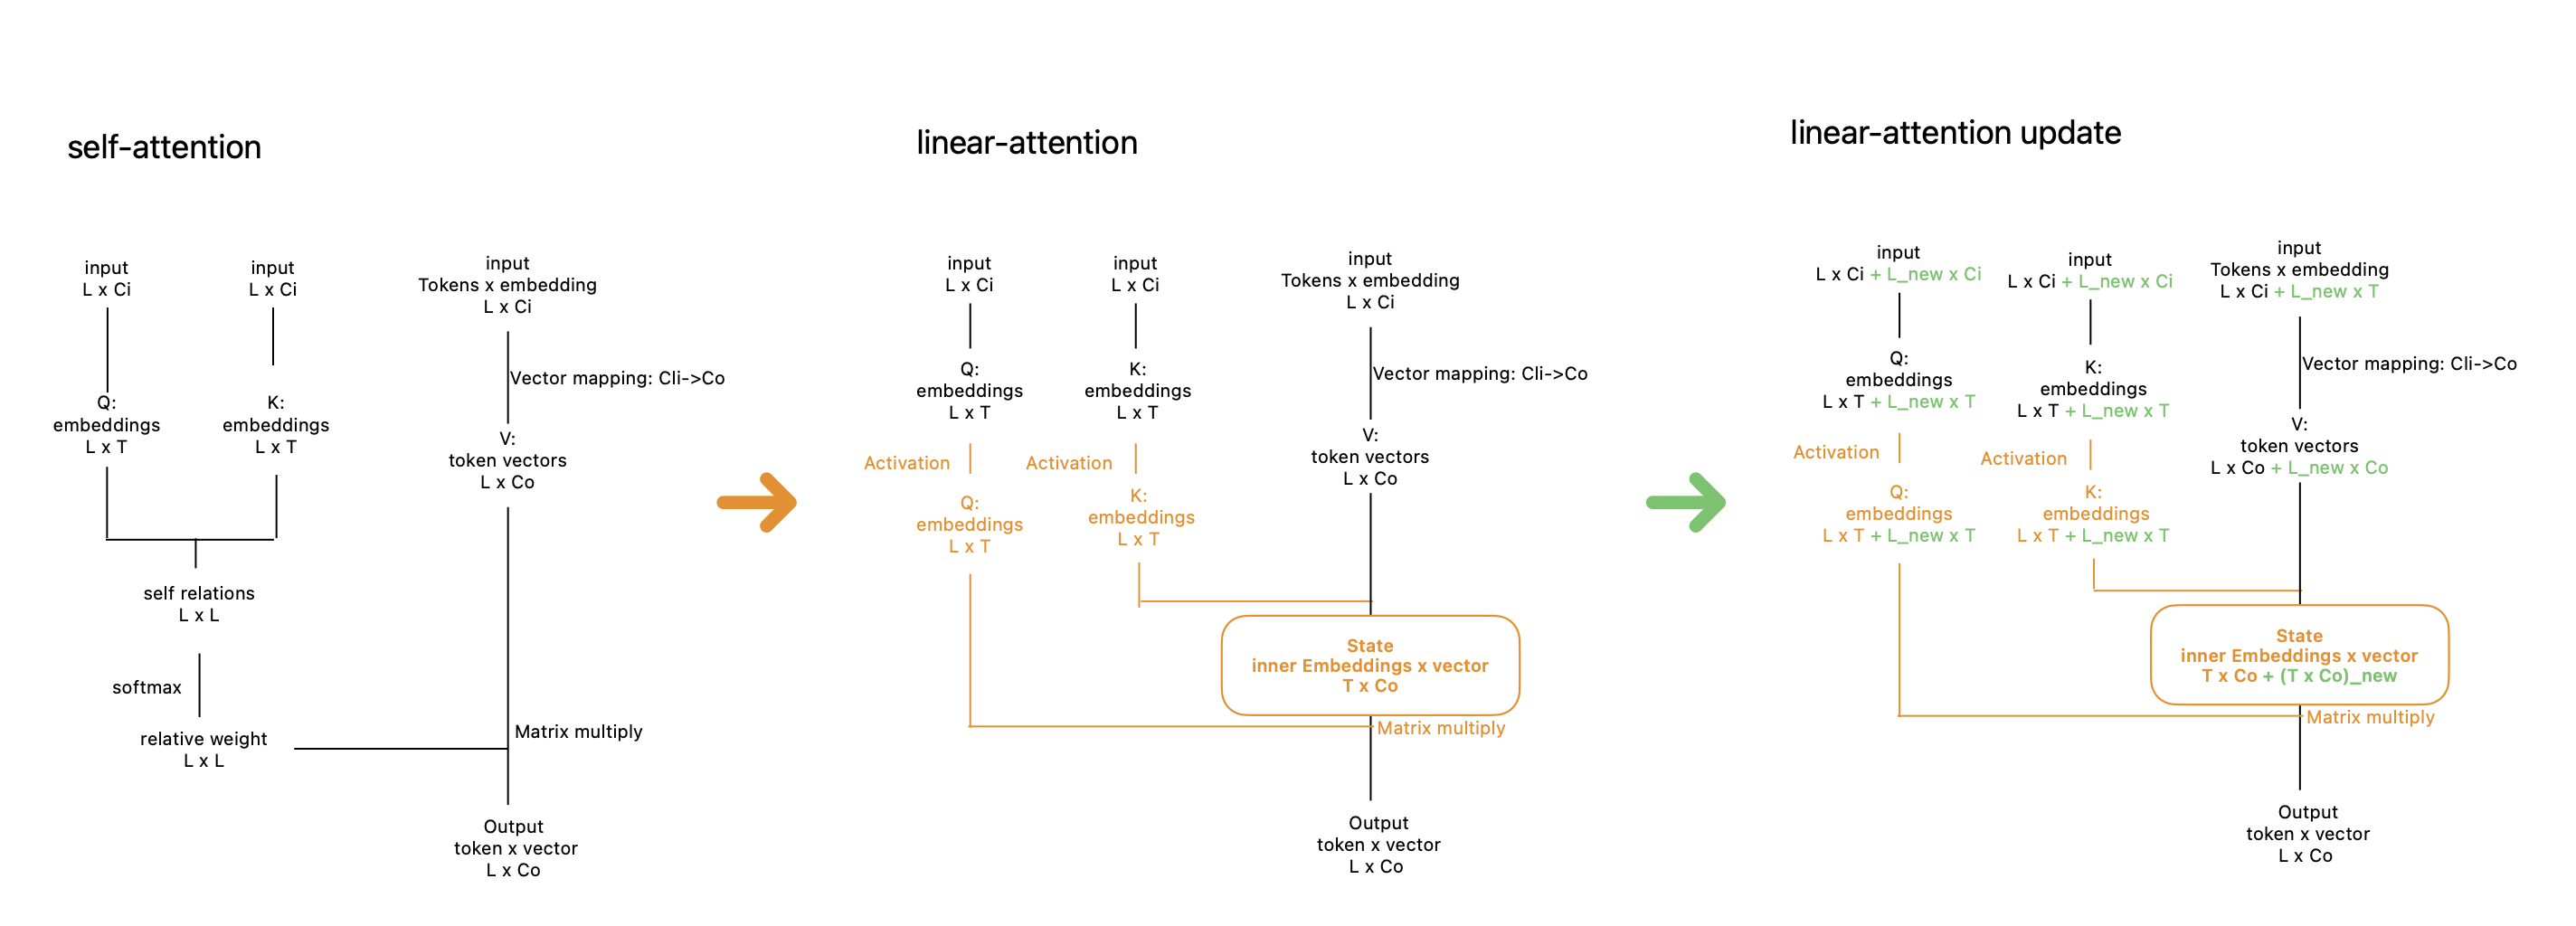
attention的优化– 引进时序结构
在token很多(大模型用的超长文本), 或者本身数据是时间序列(比如语音, 视频流)的情况下, attention里面的weight会带来$O(token^2)$ 的内存消耗. state space model可以解决这个问题.
blender学习: 做卡通描边
用solidify+背面剔除+法线翻转
stable-diffusion的结构和微调模型
stable-diffusion结构和controlnet插件
stable-diffusion的用法: 常用插件
ComfyUI使用时用到的插件
stable-diffusion的用法: 常用的作图功能-提升细节
和inpaint一样要利用stable-diffusion的图生图功能, 想让图像忠于原图的情况下提升图像细节, 解决图像模糊, 扭曲, 不合理的部分.
stable-diffusion的用法: 常用的作图功能-抠图, inpainting, 引导图
用SAM抠图
photoshop: 酸性风格海报
酸性(acid)风格 迷幻感 . 设计元素包含: 高饱和, 流动性, 未来复古元素, 格纹, 镭射金属, 霓虹色. 这个链接解释的比较详细
- 包括选用复古元素的物体(自然物体: 花鸟鱼虫, 骷髅)
blender学习: 玻璃杯
由cylinder变形得到水杯. 用cycles渲染玻璃材质.
步骤
stable-diffusion的用法: 用 lora+controlnet做风格转换
尝试只用ipadapter做猫的风格转换, 非常不成功, ipadapter还是无法控制输入的元素. 必须要用多张图片训练的LoRA才能固定ip.
另外, 猫脸上颜色分布的特征, 没有controlnet可以直接表示.
blender学习: 做火焰效果
火焰的形状用圆形变形一半获得. 用Perlin noise使坐标变形制作随机抖动. 用Emission node渲染发光效果.
stable-diffusion的用法: 用 ipadatper+controlnet canny做风格转换
用ipadapter和canny做风格转换
神经网络attention结构理解
在网络中, block是把input信息转换成output信息的过程: 一般, output(position, vector)是input(token, embedding vector)的线性组合, 组合的weight (position, token) 由input和output两方关系确定. 把着重强调这种信息交互的模块叫attention.
convolution
常用的图像 reconstruction loss
输出为图像的任务, 比如enhance, deblur, super-resolution, generation等用到的loss, 主要分为以下几类
output和label相近
龙年春联
blender学习: 用graph editor做赛博车流
步骤
blender学习: 用volume shader做气态行星
步骤
blender学习: 用displacement做动态鸟群
步骤
电子产品的频闪讨论
频闪就是亮度随时间周期性变化的情况.
传感器颜色调制 (三) – 数据
各种颜色调制的数据对难以采集, 所以现在大部分颜色调制还是用多光谱数据仿真得到.
多光谱数据集
aperture衍射模型 (二)
仿真
aperture衍射模型 (一)
光的传播理论
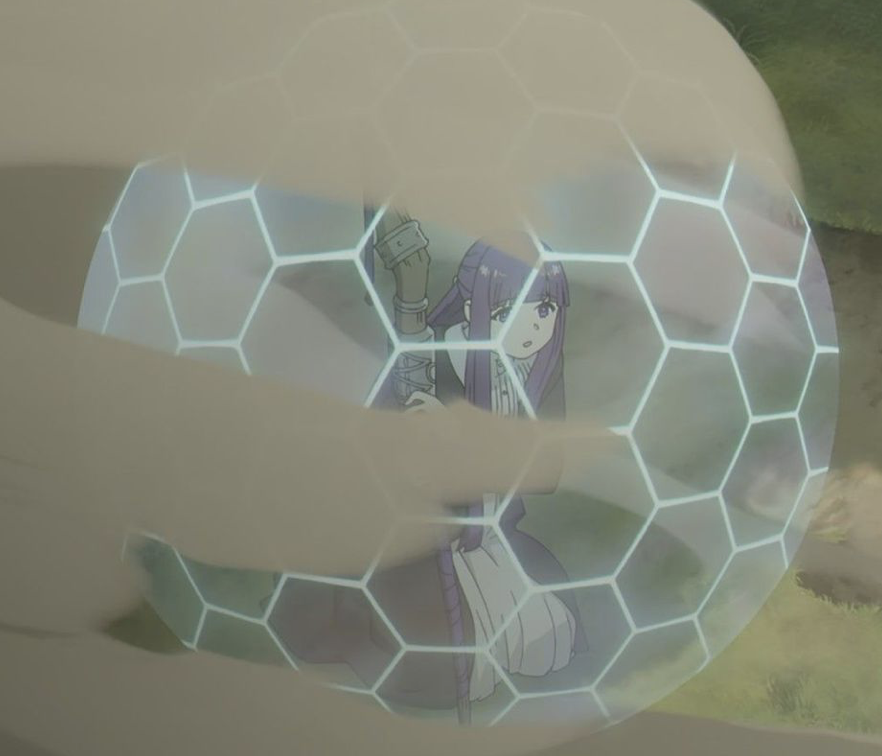
用六边形构成半球
刷到关于《葬送的芙莉莲》里面六边形魔法防御结界的讨论,根据多面体欧拉公式,仅仅用正六边形是没法组成球体形状结界。我也非常理解制作组为什么不画个足球:毕竟是魔法阵,六边形画的又比较大,弄个五边形也不好看也不好解释。
blender学习: Toon BSDF的硬阴影效果
导入模型
传感器颜色调制 (二)
其他方法进行颜色调制: coded-aperture, dispenser
传感器颜色调制 (一)
调制
双十二装机
趁着双十二激情下单,前后不到一天,选的配件都没什么性价比。
小红书学到的几种图片调色
感觉共同点是:为了追求画面简洁有冲击力,不约而同的压缩了亮度和颜色的动态范围。
版画滤镜
用 jekyll+obsidian生成个人主页并部署到 github pages的工作流
用jekyll的原因无需多说。这样配置好工作流之后,除了编写内容基本没有什么麻烦的操作(登录在线网页,换编辑器,按照统一格式改文件名之类在我看来都很麻烦。。)。
Ruby的环境管理,包管理方式
shader
blender学习: 制作水体
用displacement+noise texture制作
blender学习: 冰材质
在IOR=1.31的透明材质基础上, 添加表面的凹凸和内部的裂痕, 气泡
blender学习: 做流光效果
用金属材质反射world背景的流动
步骤:
blender学习: 玻璃杯
由cylinder变形得到水杯. 用cycles渲染玻璃材质.
步骤
blender学习: 做火焰效果
火焰的形状用圆形变形一半获得. 用Perlin noise使坐标变形制作随机抖动. 用Emission node渲染发光效果.
blender学习: 用graph editor做赛博车流
步骤
blender学习: 用volume shader做气态行星
步骤
photoshop
驾照考试
科目一
阿那亚戏剧节的海报制作
给网页添加 logo
小红书学到的几种图片调色 (二)
人物美白
画一个环形的重复图样
photoshop: 酸性风格海报
酸性(acid)风格 迷幻感 . 设计元素包含: 高饱和, 流动性, 未来复古元素, 格纹, 镭射金属, 霓虹色. 这个链接解释的比较详细
- 包括选用复古元素的物体(自然物体: 花鸟鱼虫, 骷髅)
sensor
传感器颜色调制 (四) – 多光谱颜色校准
用RGB校准多光谱数据
EMVA1288 sensor测试
aperture衍射模型 (二)
仿真
aperture衍射模型 (一)
光的传播理论
传感器颜色调制 (二)
其他方法进行颜色调制: coded-aperture, dispenser
传感器颜色调制 (一)
调制
ComfyUI
stable-diffusion的用法: 常用插件
ComfyUI使用时用到的插件
stable-diffusion的用法: 常用的作图功能-提升细节
和inpaint一样要利用stable-diffusion的图生图功能, 想让图像忠于原图的情况下提升图像细节, 解决图像模糊, 扭曲, 不合理的部分.
stable-diffusion的用法: 常用的作图功能-抠图, inpainting, 引导图
用SAM抠图
stable-diffusion的用法: 用 lora+controlnet做风格转换
尝试只用ipadapter做猫的风格转换, 非常不成功, ipadapter还是无法控制输入的元素. 必须要用多张图片训练的LoRA才能固定ip.
另外, 猫脸上颜色分布的特征, 没有controlnet可以直接表示.
stable-diffusion的用法: 用 ipadatper+controlnet canny做风格转换
用ipadapter和canny做风格转换
attention
attention的优化– KV Cache
attention的优化– flash attention加速
flash-attention是一种算子合并(kernel fusion)的优化. 把self-attention分块, 直接在SRAM里计算, 省去了HBM来回搬运中间结果S和P的时间(如下图). self-attention由两层矩阵乘法, softmax, 和其他eltwise计算(mask, dropout)构成.
attention的优化– 引进时序结构
在token很多(大模型用的超长文本), 或者本身数据是时间序列(比如语音, 视频流)的情况下, attention里面的weight会带来$O(token^2)$ 的内存消耗. state space model可以解决这个问题.
stable-diffusion的结构和微调模型
stable-diffusion结构和controlnet插件
神经网络attention结构理解
在网络中, block是把input信息转换成output信息的过程: 一般, output(position, vector)是input(token, embedding vector)的线性组合, 组合的weight (position, token) 由input和output两方关系确定. 把着重强调这种信息交互的模块叫attention.
convolution
python
代码语法解析
三元运算符(ternary)解析
worldquant BRAIN 股票因子 (三) – API使用和代码
仿真流程
协程的用法
协程就是单线程多任务, 在一个任务等待的时候干点别的其他的任务. 所以包含等待的函数都要用协程的版本: 在需要时交出event loop的控制权.
python 协程的用法
画一个环形的重复图样
pyside6一些功能的用法
pyside是qt的python封装, API的调用方法基本差不多. 用pyside从零开始写一个gui用于标注或测试(调参数或者看中间结果), 每次花费时间都比想象的要少的多. 功能方便而且代码的可读性非常好.
shortcut
blender学习: 扭曲晶体路径跟随
参考这个教学
blender学习: 用布料系统做膨胀效果
参考这个教学
小红书学到的几种图片调色 (二)
人物美白
blender学习: 几何节点做摄像头移动阵列
参考这个教学
blender学习: 玻璃杯
由cylinder变形得到水杯. 用cycles渲染玻璃材质.
步骤
homology
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
persistent homology 事例 + 应用
pair graph
conformal geometry学习 (七 ) – Duality, homology relation
conformal geometry学习 (五 ) – homology group
曲面的离散表示
llm
本地模型尝试
记录一下在 Windows 环境下配置 llama.cpp 的全过程,包括编译、启动参数调优、网络排查以及接入开发工具链的细节。
LLM接口协议梳理
梳理一下主流 LLM 接口的请求/响应结构、调用模式,以及各协议的差异,方便选型和对接时快速对照。
用大模型蒸馏人的原理与实践
资料收集 -> 按主题检索 -> 填入固定格式, 生成skill
处理新闻数据
新闻数据处理:从非结构化文本到因子矩阵
render
blender学习: 做火焰效果
火焰的形状用圆形变形一半获得. 用Perlin noise使坐标变形制作随机抖动. 用Emission node渲染发光效果.
blender学习: 用graph editor做赛博车流
步骤
blender学习: 用volume shader做气态行星
步骤
blender学习: Toon BSDF的硬阴影效果
导入模型
sdxl
stable-diffusion的用法: 常用的作图功能-提升细节
和inpaint一样要利用stable-diffusion的图生图功能, 想让图像忠于原图的情况下提升图像细节, 解决图像模糊, 扭曲, 不合理的部分.
stable-diffusion的用法: 常用的作图功能-抠图, inpainting, 引导图
用SAM抠图
stable-diffusion的用法: 用 lora+controlnet做风格转换
尝试只用ipadapter做猫的风格转换, 非常不成功, ipadapter还是无法控制输入的元素. 必须要用多张图片训练的LoRA才能固定ip.
另外, 猫脸上颜色分布的特征, 没有controlnet可以直接表示.
stable-diffusion的用法: 用 ipadatper+controlnet canny做风格转换
用ipadapter和canny做风格转换
simulation
组合交易 (一)
单个alpha仿真交易流程
worldquant BRAIN 股票因子 (一) – 仿真测试
选择在模拟盘中表现好的因子投资
aperture衍射模型 (二)
仿真
aperture衍射模型 (一)
光的传播理论
stable-diffusion
🐍 蛇年圣诞风格海报
阿那亚戏剧节的海报制作
Diffusion Process 和 Reverse Diffusion Process理解
背景知识
Bayes’ rule
stable-diffusion的结构和微调模型
stable-diffusion结构和controlnet插件
tauri
Pi Desktop的开发难点: “会话的状态”
Pi Desktop 里最难修的功能,是侧边栏那枚很小的状态 chip:这个会话现在的运行状态?
Pi Desktop:从会话浏览器到跨机器工作台
我最初只是想给 pi coding agent 补一个桌面会话浏览器:按项目查看 JSONL、展开工具调用,需要时从原会话继续聊。
Tauri 项目 Build 与 Release 实践总结
本文记录了我在使用 Tauri 构建桌面端应用时遇到的一些坑和解决方案,包括配置文件管理、macOS 编译、GitHub Actions 自动构建等内容。
worldquant BRAIN 股票因子 (六 ) – 代码优化
我最终选择了使用 Tauri 来构建我的桌面回测应用。本文记录了开发过程中需求梳理、初始化步骤、遇到的坑以及一些性能优化技巧。
3-manifold
conformal geometry学习 (七 ) – Duality, homology relation
conformal geometry学习 (四 ) – 3-manifold
3维流型, 在局部和$\mathbb R^3$ homeomorphic(同胚)
conformal geometry学习 (三 ) – Knot
Knot ($K: \mathbb S^1\rightarrow \mathbb R^3$ )
alpha
组合交易 (一)
单个alpha仿真交易流程
worldquant BRAIN 股票因子 (二) – 因子思路
一些因子的来源和原理
worldquant BRAIN 股票因子 (一) – 仿真测试
选择在模拟盘中表现好的因子投资
controlnet
stable-diffusion的结构和微调模型
stable-diffusion结构和controlnet插件
stable-diffusion的用法: 用 lora+controlnet做风格转换
尝试只用ipadapter做猫的风格转换, 非常不成功, ipadapter还是无法控制输入的元素. 必须要用多张图片训练的LoRA才能固定ip.
另外, 猫脸上颜色分布的特征, 没有controlnet可以直接表示.
stable-diffusion的用法: 用 ipadatper+controlnet canny做风格转换
用ipadapter和canny做风格转换
filter
小面积光流传感器算法测试 (三) – 滤波
在高速场景下, 每次中断收集的数据是光流的累加值, 其实本来就相当于一个滤波…况且在硬件有限的条件下, 复杂的滤波没有什么实用价值.
小红书学到的几种图片调色 (二)
人物美白
photoshop: 酸性风格海报
酸性(acid)风格 迷幻感 . 设计元素包含: 高饱和, 流动性, 未来复古元素, 格纹, 镭射金属, 霓虹色. 这个链接解释的比较详细
- 包括选用复古元素的物体(自然物体: 花鸟鱼虫, 骷髅)
fundamental_group
conformal geometry学习 (十 ) – 举例: 球面上的unit tangent bundle manifold
atlas
conformal geometry学习 (三 ) – Knot
Knot ($K: \mathbb S^1\rightarrow \mathbb R^3$ )
conformal geometry学习 (一 ) – fundamental group
fundamental group分类曲面是足够精细的
geometry_node
Back to Top ↑ipadapter
stable-diffusion的结构和微调模型
stable-diffusion结构和controlnet插件
stable-diffusion的用法: 用 lora+controlnet做风格转换
尝试只用ipadapter做猫的风格转换, 非常不成功, ipadapter还是无法控制输入的元素. 必须要用多张图片训练的LoRA才能固定ip.
另外, 猫脸上颜色分布的特征, 没有controlnet可以直接表示.
stable-diffusion的用法: 用 ipadatper+controlnet canny做风格转换
用ipadapter和canny做风格转换
jekyll
Pi Desktop:从会话浏览器到跨机器工作台
我最初只是想给 pi coding agent 补一个桌面会话浏览器:按项目查看 JSONL、展开工具调用,需要时从原会话继续聊。
给网页添加 logo
用 jekyll+obsidian生成个人主页并部署到 github pages的工作流
用jekyll的原因无需多说。这样配置好工作流之后,除了编写内容基本没有什么麻烦的操作(登录在线网页,换编辑器,按照统一格式改文件名之类在我看来都很麻烦。。)。
Ruby的环境管理,包管理方式
multi-spectrum
Back to Top ↑optical_flow
小面积光流传感器算法测试 (三) – 滤波
在高速场景下, 每次中断收集的数据是光流的累加值, 其实本来就相当于一个滤波…况且在硬件有限的条件下, 复杂的滤波没有什么实用价值.
小面积光流传感器算法测试 (二) – 特征训练
数据
小面积光流传感器算法测试 (一)
大概分为: preprocess -> instant flow compute -> filter correct 三个步骤
physics
Back to Top ↑pi
Pi Desktop的开发难点: “会话的状态”
Pi Desktop 里最难修的功能,是侧边栏那枚很小的状态 chip:这个会话现在的运行状态?
Pi Desktop:从会话浏览器到跨机器工作台
我最初只是想给 pi coding agent 补一个桌面会话浏览器:按项目查看 JSONL、展开工具调用,需要时从原会话继续聊。
本地模型尝试
记录一下在 Windows 环境下配置 llama.cpp 的全过程,包括编译、启动参数调优、网络排查以及接入开发工具链的细节。
AI
用AI做了一套微信表情包:从微信头像缓存到提交上架
目标:把历史微信头像(都是我家猫的照片)做成一套微信表情包,并在微信表情开放平台提交上架。
用大模型蒸馏人的原理与实践
资料收集 -> 按主题检索 -> 填入固定格式, 生成skill
Alpha
动态调整搜索优先级:从 PROSAC 到 Alpha 实战演进
在量化回测中,Alpha 搜索不仅仅是一个算力问题,更是一个资源分配问题。传统的 RANSAC(随机采样一致性)在面对海量 Datafields 时效率极低,而 PROSAC 提供了一种渐进式(Progressive)的思考框架。
因子组合优化
问题: 从 $N$ 个候选集中挑选出 $K$ 个,构建一个能够最大化综合得分的组合。得分计算复杂, 所以我们考虑启发式的算法.
Optimization
动态调整搜索优先级:从 PROSAC 到 Alpha 实战演进
在量化回测中,Alpha 搜索不仅仅是一个算力问题,更是一个资源分配问题。传统的 RANSAC(随机采样一致性)在面对海量 Datafields 时效率极低,而 PROSAC 提供了一种渐进式(Progressive)的思考框架。
因子组合优化
问题: 从 $N$ 个候选集中挑选出 $K$ 个,构建一个能够最大化综合得分的组合。得分计算复杂, 所以我们考虑启发式的算法.
async
worldquant BRAIN 股票因子 (三) – API使用和代码
仿真流程
协程的用法
协程就是单线程多任务, 在一个任务等待的时候干点别的其他的任务. 所以包含等待的函数都要用协程的版本: 在需要时交出event loop的控制权.
python 协程的用法
blender
🐍 蛇年圣诞风格海报
photoshop: 酸性风格海报
酸性(acid)风格 迷幻感 . 设计元素包含: 高饱和, 流动性, 未来复古元素, 格纹, 镭射金属, 霓虹色. 这个链接解释的比较详细
- 包括选用复古元素的物体(自然物体: 花鸟鱼虫, 骷髅)
canny
stable-diffusion的用法: 用 lora+controlnet做风格转换
尝试只用ipadapter做猫的风格转换, 非常不成功, ipadapter还是无法控制输入的元素. 必须要用多张图片训练的LoRA才能固定ip.
另外, 猫脸上颜色分布的特征, 没有controlnet可以直接表示.
stable-diffusion的用法: 用 ipadatper+controlnet canny做风格转换
用ipadapter和canny做风格转换
cohomology
conformal geometry学习 (十一 ) – Hodge Star Operator
Hodge Star Operator
conformal geometry学习 (六 ) – cohomology group
上同调是同调的对偶
data_structure
处理新闻数据
新闻数据处理:从非结构化文本到因子矩阵
各种 moving function
场景
moving mean
dsl
代码语法解析
三元运算符(ternary)解析
给 VsCode 安装插件
euler_character
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
conformal geometry学习 (七 ) – Duality, homology relation
homotopy
conformal geometry学习 (二 ) – Universal Covering
covering space
conformal geometry学习 (一 ) – fundamental group
fundamental group分类曲面是足够精细的
hyperbolic_geometry
conformal geometry学习 (四 ) – 3-manifold
3维流型, 在局部和$\mathbb R^3$ homeomorphic(同胚)
conformal geometry学习 (二 ) – Universal Covering
covering space
isp
传感器颜色调制 (四) – 多光谱颜色校准
用RGB校准多光谱数据
EMVA1288 sensor测试
knot
conformal geometry学习 (四 ) – 3-manifold
3维流型, 在局部和$\mathbb R^3$ homeomorphic(同胚)
conformal geometry学习 (三 ) – Knot
Knot ($K: \mathbb S^1\rightarrow \mathbb R^3$ )
macOS
Pi Desktop的开发难点: “会话的状态”
Pi Desktop 里最难修的功能,是侧边栏那枚很小的状态 chip:这个会话现在的运行状态?
Pi Desktop:从会话浏览器到跨机器工作台
我最初只是想给 pi coding agent 补一个桌面会话浏览器:按项目查看 JSONL、展开工具调用,需要时从原会话继续聊。
macos
Tauri 项目 Build 与 Release 实践总结
本文记录了我在使用 Tauri 构建桌面端应用时遇到的一些坑和解决方案,包括配置文件管理、macOS 编译、GitHub Actions 自动构建等内容。
设置开机自启动自运行程序
macos
opencv
小面积光流传感器算法测试 (一)
大概分为: preprocess -> instant flow compute -> filter correct 三个步骤
画一个环形的重复图样
persistent_homology
persistent homology 事例 + 应用
pair graph
conformal geometry学习 (八 ) – Persistent homology
一种计算 $H_k(\Sigma,\mathbb Z_2)$ 的方法, 计算filtration $\mathbb K$ 中homology的变化
raycast
raycast脚本
用 jekyll+obsidian生成个人主页并部署到 github pages的工作流
用jekyll的原因无需多说。这样配置好工作流之后,除了编写内容基本没有什么麻烦的操作(登录在线网页,换编辑器,按照统一格式改文件名之类在我看来都很麻烦。。)。
Ruby的环境管理,包管理方式
rmux
Pi Desktop的开发难点: “会话的状态”
Pi Desktop 里最难修的功能,是侧边栏那枚很小的状态 chip:这个会话现在的运行状态?
Pi Desktop:从会话浏览器到跨机器工作台
我最初只是想给 pi coding agent 补一个桌面会话浏览器:按项目查看 JSONL、展开工具调用,需要时从原会话继续聊。
sampling
stable-diffusion中 k-sampling的不同版本 (二 )
ComfyUI中的一些代码实现
stable-diffusion中 k-sampling的不同版本 (一 )
背景知识
script
blender学习: 几何节点做摄像头移动阵列
参考这个教学
传感器颜色调制 (三) – 数据
各种颜色调制的数据对难以采集, 所以现在大部分颜色调制还是用多光谱数据仿真得到.
多光谱数据集
stock
worldquant BRAIN 股票因子 (二) – 因子思路
一些因子的来源和原理
worldquant BRAIN 股票因子 (一) – 仿真测试
选择在模拟盘中表现好的因子投资
tangent_vector_field
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
conformal geometry学习 (六 ) – cohomology group
上同调是同调的对偶
test
小面积光流传感器算法测试 (一)
大概分为: preprocess -> instant flow compute -> filter correct 三个步骤
电子产品的频闪讨论
频闪就是亮度随时间周期性变化的情况.
utm
conformal geometry学习 (十 ) – 举例: 球面上的unit tangent bundle manifold
atlas
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
vue
Tauri 项目 Build 与 Release 实践总结
本文记录了我在使用 Tauri 构建桌面端应用时遇到的一些坑和解决方案,包括配置文件管理、macOS 编译、GitHub Actions 自动构建等内容。
worldquant BRAIN 股票因子 (六 ) – 代码优化
我最终选择了使用 Tauri 来构建我的桌面回测应用。本文记录了开发过程中需求梳理、初始化步骤、遇到的坑以及一些性能优化技巧。
worldquant
worldquant BRAIN 股票因子 (六 ) – 代码优化
我最终选择了使用 Tauri 来构建我的桌面回测应用。本文记录了开发过程中需求梳理、初始化步骤、遇到的坑以及一些性能优化技巧。
worldquant BRAIN 股票因子 (三) – API使用和代码
仿真流程
日用品
常用消毒液成分分类与安全性调研
核心成分与使用全图谱
洗发水成分
成分分类
粒子系统
blender学习: 用粒子系统做毛毡效果
步骤:
blender学习: 做火焰效果
火焰的形状用圆形变形一半获得. 用Perlin noise使坐标变形制作随机抖动. 用Emission node渲染发光效果.
3d_model
blender学习: 玻璃杯
由cylinder变形得到水杯. 用cycles渲染玻璃材质.
步骤
3d_rotation
Back to Top ↑BSDF
Back to Top ↑Cech_complex
conformal geometry学习 (八 ) – Persistent homology
一种计算 $H_k(\Sigma,\mathbb Z_2)$ 的方法, 计算filtration $\mathbb K$ 中homology的变化
DDPM
Back to Top ↑EMVA1288
Back to Top ↑GA
因子组合优化
问题: 从 $N$ 个候选集中挑选出 $K$ 个,构建一个能够最大化综合得分的组合。得分计算复杂, 所以我们考虑启发式的算法.
Gauss_Bonnet
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
Gemini
用AI做了一套微信表情包:从微信头像缓存到提交上架
目标:把历史微信头像(都是我家猫的照片)做成一套微信表情包,并在微信表情开放平台提交上架。
Greedy
因子组合优化
问题: 从 $N$ 个候选集中挑选出 $K$ 个,构建一个能够最大化综合得分的组合。得分计算复杂, 所以我们考虑启发式的算法.
L1_norm
组合交易 (一)
单个alpha仿真交易流程
Lagrange_multiplier
拉格朗日乘子法应用 (一 )
拉格朗日乘子法(Lagrange multiplier )一般问题
Lefschetz_number
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
Mamba
attention的优化– 引进时序结构
在token很多(大模型用的超长文本), 或者本身数据是时间序列(比如语音, 视频流)的情况下, attention里面的weight会带来$O(token^2)$ 的内存消耗. state space model可以解决这个问题.
Markov_chain
Back to Top ↑Markowitz_model
拉格朗日乘子法应用 (一 )
拉格朗日乘子法(Lagrange multiplier )一般问题
Mongodb
worldquant BRAIN 股票因子 (六 ) – 代码优化
我最终选择了使用 Tauri 来构建我的桌面回测应用。本文记录了开发过程中需求梳理、初始化步骤、遇到的坑以及一些性能优化技巧。
PROSAC
动态调整搜索优先级:从 PROSAC 到 Alpha 实战演进
在量化回测中,Alpha 搜索不仅仅是一个算力问题,更是一个资源分配问题。传统的 RANSAC(随机采样一致性)在面对海量 Datafields 时效率极低,而 PROSAC 提供了一种渐进式(Progressive)的思考框架。
Playwright
用AI做了一套微信表情包:从微信头像缓存到提交上架
目标:把历史微信头像(都是我家猫的照片)做成一套微信表情包,并在微信表情开放平台提交上架。
Portfolio
因子组合优化
问题: 从 $N$ 个候选集中挑选出 $K$ 个,构建一个能够最大化综合得分的组合。得分计算复杂, 所以我们考虑启发式的算法.
RAG
处理新闻数据
新闻数据处理:从非结构化文本到因子矩阵
Riemann_metric
conformal geometry学习 (十一 ) – Hodge Star Operator
Hodge Star Operator
SMLD
Back to Top ↑SSM
attention的优化– 引进时序结构
在token很多(大模型用的超长文本), 或者本身数据是时间序列(比如语音, 视频流)的情况下, attention里面的weight会带来$O(token^2)$ 的内存消耗. state space model可以解决这个问题.
Search
动态调整搜索优先级:从 PROSAC 到 Alpha 实战演进
在量化回测中,Alpha 搜索不仅仅是一个算力问题,更是一个资源分配问题。传统的 RANSAC(随机采样一致性)在面对海量 Datafields 时效率极低,而 PROSAC 提供了一种渐进式(Progressive)的思考框架。
Seifert_surface
conformal geometry学习 (三 ) – Knot
Knot ($K: \mathbb S^1\rightarrow \mathbb R^3$ )
Tessellation
用六边形构成半球
刷到关于《葬送的芙莉莲》里面六边形魔法防御结界的讨论,根据多面体欧拉公式,仅仅用正六边形是没法组成球体形状结界。我也非常理解制作组为什么不画个足球:毕竟是魔法阵,六边形画的又比较大,弄个五边形也不好看也不好解释。
Trichotomy
conformal geometry学习 (三 ) – Knot
Knot ($K: \mathbb S^1\rightarrow \mathbb R^3$ )
acid
photoshop: 酸性风格海报
酸性(acid)风格 迷幻感 . 设计元素包含: 高饱和, 流动性, 未来复古元素, 格纹, 镭射金属, 霓虹色. 这个链接解释的比较详细
- 包括选用复古元素的物体(自然物体: 花鸟鱼虫, 骷髅)
adaboost
Back to Top ↑ast
代码语法解析
三元运算符(ternary)解析
atlas
Back to Top ↑barcode
persistent homology 事例 + 应用
pair graph
basic
各种 moving function
场景
moving mean
betti_number
Back to Top ↑block
神经网络attention结构理解
在网络中, block是把input信息转换成output信息的过程: 一般, output(position, vector)是input(token, embedding vector)的线性组合, 组合的weight (position, token) 由input和output两方关系确定. 把着重强调这种信息交互的模块叫attention.
convolution
build
Tauri 项目 Build 与 Release 实践总结
本文记录了我在使用 Tauri 构建桌面端应用时遇到的一些坑和解决方案,包括配置文件管理、macOS 编译、GitHub Actions 自动构建等内容。
camera
blender学习: 镜头推移
前向推镜头
camera_raw
小红书学到的几种图片调色 (二)
人物美白
chain
Back to Top ↑characteristic_class
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
claude_code
本地模型尝试
记录一下在 Windows 环境下配置 llama.cpp 的全过程,包括编译、启动参数调优、网络排查以及接入开发工具链的细节。
color
小红书学到的几种图片调色 (二)
人物美白
combo
组合交易 (一)
单个alpha仿真交易流程
contrastive_learning
Back to Top ↑cover
conformal geometry学习 (二 ) – Universal Covering
covering space
curve
blender学习: 做流光效果
用金属材质反射world背景的流动
步骤:
data
处理新闻数据
新闻数据处理:从非结构化文本到因子矩阵
dataset
传感器颜色调制 (三) – 数据
各种颜色调制的数据对难以采集, 所以现在大部分颜色调制还是用多光谱数据仿真得到.
多光谱数据集
de_Rham_cohomology
Back to Top ↑debugging
Pi Desktop的开发难点: “会话的状态”
Pi Desktop 里最难修的功能,是侧边栏那枚很小的状态 chip:这个会话现在的运行状态?
deck_transformation
conformal geometry学习 (二 ) – Universal Covering
covering space
deeplearning
Back to Top ↑degree_of_mapping
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
design
photoshop: 酸性风格海报
酸性(acid)风格 迷幻感 . 设计元素包含: 高饱和, 流动性, 未来复古元素, 格纹, 镭射金属, 霓虹色. 这个链接解释的比较详细
- 包括选用复古元素的物体(自然物体: 花鸟鱼虫, 骷髅)
device
双十二装机
趁着双十二激情下单,前后不到一天,选的配件都没什么性价比。
differential_form
Back to Top ↑diffusion
Back to Top ↑discrete
Back to Top ↑disinfectant
常用消毒液成分分类与安全性调研
核心成分与使用全图谱
dpm-solver
Back to Top ↑dual_mesh
conformal geometry学习 (十一 ) – Hodge Star Operator
Hodge Star Operator
duality
Back to Top ↑equal_weight
组合交易 (一)
单个alpha仿真交易流程
fiber_bundle
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
filtration
conformal geometry学习 (八 ) – Persistent homology
一种计算 $H_k(\Sigma,\mathbb Z_2)$ 的方法, 计算filtration $\mathbb K$ 中homology的变化
fix_point
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
flash attention
attention的优化– flash attention加速
flash-attention是一种算子合并(kernel fusion)的优化. 把self-attention分块, 直接在SRAM里计算, 省去了HBM来回搬运中间结果S和P的时间(如下图). self-attention由两层矩阵乘法, softmax, 和其他eltwise计算(mask, dropout)构成.
gaussian_map
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
genus
conformal geometry学习 (三 ) – Knot
Knot ($K: \mathbb S^1\rightarrow \mathbb R^3$ )
github
Tauri 项目 Build 与 Release 实践总结
本文记录了我在使用 Tauri 构建桌面端应用时遇到的一些坑和解决方案,包括配置文件管理、macOS 编译、GitHub Actions 自动构建等内容。
github_actions
Tauri 项目 Build 与 Release 实践总结
本文记录了我在使用 Tauri 构建桌面端应用时遇到的一些坑和解决方案,包括配置文件管理、macOS 编译、GitHub Actions 自动构建等内容。
gligen
stable-diffusion的结构和微调模型
stable-diffusion结构和controlnet插件
gpu
attention的优化– flash attention加速
flash-attention是一种算子合并(kernel fusion)的优化. 把self-attention分块, 直接在SRAM里计算, 省去了HBM来回搬运中间结果S和P的时间(如下图). self-attention由两层矩阵乘法, softmax, 和其他eltwise计算(mask, dropout)构成.
graph
persistent homology 事例 + 应用
pair graph
grid_sample
Back to Top ↑gui
pyside6一些功能的用法
pyside是qt的python封装, API的调用方法基本差不多. 用pyside从零开始写一个gui用于标注或测试(调参数或者看中间结果), 每次花费时间都比想象的要少的多. 功能方便而且代码的可读性非常好.
hair
Back to Top ↑harmonic_energy
conformal geometry学习 (十一 ) – Hodge Star Operator
Hodge Star Operator
harmonic_form
conformal geometry学习 (十一 ) – Hodge Star Operator
Hodge Star Operator
harmonic_function
conformal geometry学习 (十一 ) – Hodge Star Operator
Hodge Star Operator
harmonic_map
conformal geometry学习 (十一 ) – Hodge Star Operator
Hodge Star Operator
hex
用六边形构成半球
刷到关于《葬送的芙莉莲》里面六边形魔法防御结界的讨论,根据多面体欧拉公式,仅仅用正六边形是没法组成球体形状结界。我也非常理解制作组为什么不画个足球:毕竟是魔法阵,六边形画的又比较大,弄个五边形也不好看也不好解释。
hodge_star
conformal geometry学习 (十一 ) – Hodge Star Operator
Hodge Star Operator
homeomorphic
conformal geometry学习 (一 ) – fundamental group
fundamental group分类曲面是足够精细的
hp
猫幽门螺杆菌调查
一篇关于猫幽门螺杆菌的实验论文
hugging_face
本地模型尝试
记录一下在 Windows 环境下配置 llama.cpp 的全过程,包括编译、启动参数调优、网络排查以及接入开发工具链的细节。
idea
用六边形构成半球
刷到关于《葬送的芙莉莲》里面六边形魔法防御结界的讨论,根据多面体欧拉公式,仅仅用正六边形是没法组成球体形状结界。我也非常理解制作组为什么不画个足球:毕竟是魔法阵,六边形画的又比较大,弄个五边形也不好看也不好解释。
image
常用的图像 reconstruction loss
输出为图像的任务, 比如enhance, deblur, super-resolution, generation等用到的loss, 主要分为以下几类
output和label相近
index
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
inpaint
Back to Top ↑isotopic
conformal geometry学习 (三 ) – Knot
Knot ($K: \mathbb S^1\rightarrow \mathbb R^3$ )
kalman
小面积光流传感器算法测试 (三) – 滤波
在高速场景下, 每次中断收集的数据是光流的累加值, 其实本来就相当于一个滤波…况且在硬件有限的条件下, 复杂的滤波没有什么实用价值.
lcm
Back to Top ↑leetcode
各种 moving function
场景
moving mean
life
双十二装机
趁着双十二激情下单,前后不到一天,选的配件都没什么性价比。
lift
conformal geometry学习 (二 ) – Universal Covering
covering space
linear attention
attention的优化– 引进时序结构
在token很多(大模型用的超长文本), 或者本身数据是时间序列(比如语音, 视频流)的情况下, attention里面的weight会带来$O(token^2)$ 的内存消耗. state space model可以解决这个问题.
llama
本地模型尝试
记录一下在 Windows 环境下配置 llama.cpp 的全过程,包括编译、启动参数调优、网络排查以及接入开发工具链的细节。
logo
Back to Top ↑lora
stable-diffusion的结构和微调模型
stable-diffusion结构和controlnet插件
loss
常用的图像 reconstruction loss
输出为图像的任务, 比如enhance, deblur, super-resolution, generation等用到的loss, 主要分为以下几类
output和label相近
manifold
Back to Top ↑markdown
用 jekyll+obsidian生成个人主页并部署到 github pages的工作流
用jekyll的原因无需多说。这样配置好工作流之后,除了编写内容基本没有什么麻烦的操作(登录在线网页,换编辑器,按照统一格式改文件名之类在我看来都很麻烦。。)。
Ruby的环境管理,包管理方式
material
blender学习: 做卡通描边
用solidify+背面剔除+法线翻转
mesh
四边形网格生成
->
modifier
blender学习: 做卡通描边
用solidify+背面剔除+法线翻转
music
Back to Top ↑network
神经网络attention结构理解
在网络中, block是把input信息转换成output信息的过程: 一般, output(position, vector)是input(token, embedding vector)的线性组合, 组合的weight (position, token) 由input和output两方关系确定. 把着重强调这种信息交互的模块叫attention.
convolution
news
处理新闻数据
新闻数据处理:从非结构化文本到因子矩阵
noise
Back to Top ↑norm
小面积光流传感器算法测试 (三) – 滤波
在高速场景下, 每次中断收集的数据是光流的累加值, 其实本来就相当于一个滤波…况且在硬件有限的条件下, 复杂的滤波没有什么实用价值.
obsidian
用 jekyll+obsidian生成个人主页并部署到 github pages的工作流
用jekyll的原因无需多说。这样配置好工作流之后,除了编写内容基本没有什么麻烦的操作(登录在线网页,换编辑器,按照统一格式改文件名之类在我看来都很麻烦。。)。
Ruby的环境管理,包管理方式
obstruction
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
pair_graph
persistent homology 事例 + 应用
pair graph
parser
代码语法解析
三元运算符(ternary)解析
pid
Back to Top ↑pipeline
处理新闻数据
新闻数据处理:从非结构化文本到因子矩阵
point_cloud
persistent homology 事例 + 应用
pair graph
pratt
代码语法解析
三元运算符(ternary)解析
proximal_operator
传感器颜色调制 (四) – 多光谱颜色校准
用RGB校准多光谱数据
pyside6
pyside6一些功能的用法
pyside是qt的python封装, API的调用方法基本差不多. 用pyside从零开始写一个gui用于标注或测试(调参数或者看中间结果), 每次花费时间都比想象的要少的多. 功能方便而且代码的可读性非常好.
pytorch
传感器颜色调制 (三) – 数据
各种颜色调制的数据对难以采集, 所以现在大部分颜色调制还是用多光谱数据仿真得到.
多光谱数据集
quad-mesh
四边形网格生成
->
qwen
本地模型尝试
记录一下在 Windows 环境下配置 llama.cpp 的全过程,包括编译、启动参数调优、网络排查以及接入开发工具链的细节。
refine
stable-diffusion的用法: 常用的作图功能-提升细节
和inpaint一样要利用stable-diffusion的图生图功能, 想让图像忠于原图的情况下提升图像细节, 解决图像模糊, 扭曲, 不合理的部分.
regularization
代码语法解析
三元运算符(ternary)解析
rust
Tauri 项目 Build 与 Release 实践总结
本文记录了我在使用 Tauri 构建桌面端应用时遇到的一些坑和解决方案,包括配置文件管理、macOS 编译、GitHub Actions 自动构建等内容。
sci-pop
电子产品的频闪讨论
频闪就是亮度随时间周期性变化的情况.
sde
Back to Top ↑search
处理新闻数据
新闻数据处理:从非结构化文本到因子矩阵
sentiment
处理新闻数据
新闻数据处理:从非结构化文本到因子矩阵
shampoo
洗发水成分
成分分类
simplex
Back to Top ↑simplical_complex
Back to Top ↑simplicial_cohomology
Back to Top ↑solidify
blender学习: 做卡通描边
用solidify+背面剔除+法线翻转
speedup
attention的优化– flash attention加速
flash-attention是一种算子合并(kernel fusion)的优化. 把self-attention分块, 直接在SRAM里计算, 省去了HBM来回搬运中间结果S和P的时间(如下图). self-attention由两层矩阵乘法, softmax, 和其他eltwise计算(mask, dropout)构成.
standard
Back to Top ↑state
attention的优化– 引进时序结构
在token很多(大模型用的超长文本), 或者本身数据是时间序列(比如语音, 视频流)的情况下, attention里面的weight会带来$O(token^2)$ 的内存消耗. state space model可以解决这个问题.
state space model
attention的优化– 引进时序结构
在token很多(大模型用的超长文本), 或者本身数据是时间序列(比如语音, 视频流)的情况下, attention里面的weight会带来$O(token^2)$ 的内存消耗. state space model可以解决这个问题.
stoke
blender学习: 做卡通描边
用solidify+背面剔除+法线翻转
string
代码语法解析
三元运算符(ternary)解析
tda
persistent homology 事例 + 应用
pair graph
ternary
代码语法解析
三元运算符(ternary)解析
time series
attention的优化– 引进时序结构
在token很多(大模型用的超长文本), 或者本身数据是时间序列(比如语音, 视频流)的情况下, attention里面的weight会带来$O(token^2)$ 的内存消耗. state space model可以解决这个问题.
topological_data_analysis
persistent homology 事例 + 应用
pair graph
track
Back to Top ↑triangulation
Back to Top ↑typescript
Back to Top ↑uni-pc
Back to Top ↑universal_cover
conformal geometry学习 (二 ) – Universal Covering
covering space
vector_field
Back to Top ↑video_editor
Back to Top ↑vscode
Back to Top ↑zero_point
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
三角剖分
Back to Top ↑不动点定理
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
动漫
用六边形构成半球
刷到关于《葬送的芙莉莲》里面六边形魔法防御结界的讨论,根据多面体欧拉公式,仅仅用正六边形是没法组成球体形状结界。我也非常理解制作组为什么不画个足球:毕竟是魔法阵,六边形画的又比较大,弄个五边形也不好看也不好解释。
发旋定理
conformal geometry学习 (九 ) – homology character
由基本群/同调群定义指标
宠物安全
常用消毒液成分分类与安全性调研
核心成分与使用全图谱
异步
协程的用法
协程就是单线程多任务, 在一个任务等待的时候干点别的其他的任务. 所以包含等待的函数都要用协程的版本: 在需要时交出event loop的控制权.
python 协程的用法
微信
用AI做了一套微信表情包:从微信头像缓存到提交上架
目标:把历史微信头像(都是我家猫的照片)做成一套微信表情包,并在微信表情开放平台提交上架。
电场
conformal geometry学习 (十一 ) – Hodge Star Operator
Hodge Star Operator
胃病
猫幽门螺杆菌调查
一篇关于猫幽门螺杆菌的实验论文
蒸馏
用大模型蒸馏人的原理与实践
资料收集 -> 按主题检索 -> 填入固定格式, 生成skill
表情包
用AI做了一套微信表情包:从微信头像缓存到提交上架
目标:把历史微信头像(都是我家猫的照片)做成一套微信表情包,并在微信表情开放平台提交上架。
醒图
小红书学到的几种图片调色
感觉共同点是:为了追求画面简洁有冲击力,不约而同的压缩了亮度和颜色的动态范围。