
背景知识
Bayes’ rule
\[p(c\vert a,b) = p(a\vert c)\frac{p(c\vert b)}{p(a\vert b)}\propto p(a\vert c)p(c\vert b)\]- 考虑一种特殊情况:
- RHS都是高斯分布: $p(a\vert c)\propto e^{-\frac{(a-\mu_{c\rightarrow a})^2}{2(\sigma_{c\rightarrow a})^2}}$, $p(c\vert b)\propto e^{-\frac{(c-\mu_{b\rightarrow c})^2}{2(\sigma_{b\rightarrow c})^2}}$, $p(a\vert b)\propto e^{-\frac{(a-\mu_{b\rightarrow a})^2}{2(\sigma_{b\rightarrow a})^2}}$
- 且其中均值是关于条件变量线性的, $\mu_{c\rightarrow a}=\kappa_{c\rightarrow a}\cdot c$ , $\mu_{c\rightarrow b}=\kappa_{c\rightarrow b}\cdot b$, $\mu_{a\rightarrow b}=\kappa_{a\rightarrow b}\cdot b$, 方差是常数
- 则$p(c\vert a,b)$ 也同样为高斯分布
- 把Bayers’ rule转成log形式: $\log p(c\vert a,b)=\log p(a\vert c) +\log p(c\vert b) +C =-\frac{(a-\kappa_{c\rightarrow a}\cdot c)^2}{2(\sigma_{c\rightarrow a})^2}-\frac{(c-\kappa_{b\rightarrow c}\cdot b)^2}{2(\sigma_{b\rightarrow c})^2}+C$
- 可以看到RHS依然是关于c 的二次多项式
- 由c的二次项系数得到方差$\frac{1}{\sigma^2}=\frac{\kappa_{c\rightarrow a}^2}{\sigma_{c\rightarrow a}^2}+\frac{1}{\sigma_{b\rightarrow c}^2}$
- 由c的一次项系数得到均值$\frac{\mu}{\sigma^2}=\frac{\kappa_{c\rightarrow a}\cdot a}{\sigma_{c\rightarrow a}^2}+\frac{\kappa_{b\rightarrow c}\cdot b}{\sigma_{b\rightarrow c}^2}$
SDE(stochastic differential equation)
把DPM表示成 SDE(stochastic differential equation):
- SDE的一般形式: $dx=f(x,t)dt+g(t)dw$
- $f(\cdot,t)$ 是drift coefficients 表示确定的部分
- $g(\cdot)$ 是diffusion coefficients 表示随机部分参数
- $\omega$ 是Wiener process(布朗运动) , $dw=\sqrt{t}z, z\sim N(0,1)$
- SDE的reverse: $dx=(f(x,t)-\frac{1}{2}g^2(t)\nabla_x\log p(x,t))dt+g(t)dw$
- score function $\nabla_x\log p(x,t)$ 指向higher density of data
- 前半确定部分: Probability flow ODE: $dx=(f(x,t)-\frac{1}{2}g^2(t)\nabla_x\log p(x,t))dt$
Diffusion Process & Reverse Diffusion Process
Diffusion Process
$q(x_t\vert x_0)=N(x_t;\alpha_t x_0,\sigma^2 I)$ diffusion收敛到SDE, SDE离散化得到diffusion. Denoising diffusion probabilistic modeling (DDPM) 和Score matching with Langevin dynamics (SMLD) 可以看作两种不同的实例化.
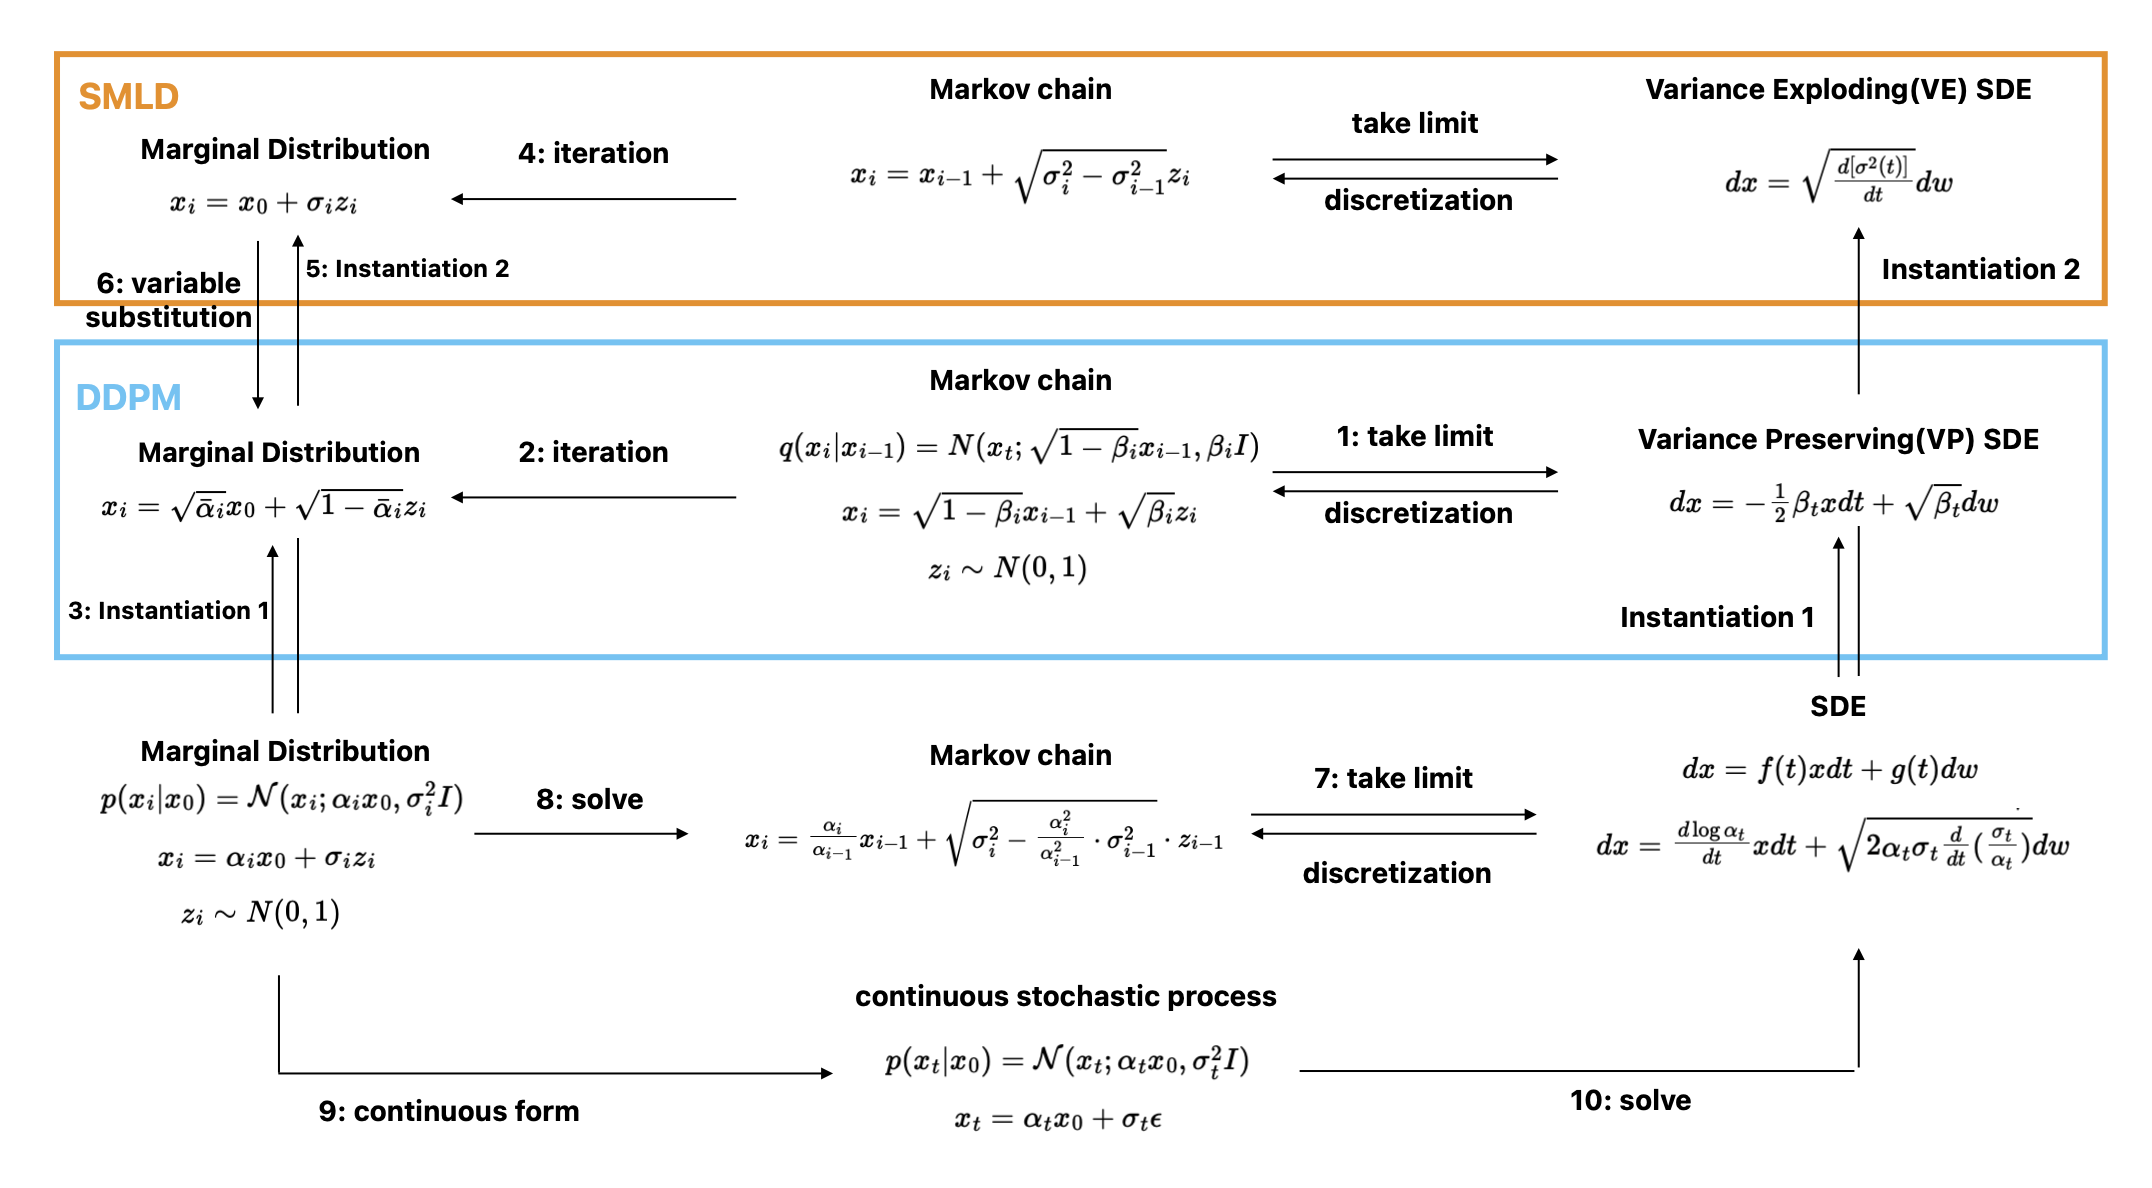
- DDPM(see [3] Appendix B.) to Variance Preserving(VP) SDE
- $x_i=\sqrt{1-\beta_i}x_{i-1}+\sqrt{\beta_i}z_i$ $\implies$ $x_i-x_{i-1}=(\sqrt{1-\beta_i}-1)x_{i-1}+\sqrt{\beta_i}z_i$
- LHS: $x_i-x_{i-1}\rightarrow dx$
- RHS: $\sqrt{1-\beta_i}x_{i-1}+\sqrt{\beta_i}z_i\rightarrow (\frac{\sqrt{1-\beta(t)dt}\ -1}{dt})xdt+\sqrt{\beta(t)dt}\frac{dw}{\sqrt{dt}}\rightarrow -\frac{1}{2}\beta(t)xdt+\sqrt{\beta(t)}dw$
- 其中, $z_i\rightarrow \frac{dw}{\sqrt{dt}}$ , $\beta_i\rightarrow \beta(t)dt$
- $lim_{dt\rightarrow 0} \frac{\sqrt{1-\beta(t)dt}-1}{dt}=-\frac{1}{2}\beta(t)$
- $x_i=\sqrt{1-\beta_i}x_{i-1}+\sqrt{\beta_i}z_i$ $\implies$ $x_i-x_{i-1}=(\sqrt{1-\beta_i}-1)x_{i-1}+\sqrt{\beta_i}z_i$
- DDPM Markov chain to Marginal Distribution
- $x_i=\sqrt{1-\beta_i}x_{i-1}+\sqrt{\beta_i}z_i=\sqrt{1-\beta_i}(\sqrt{1-\beta_{i-1}}x_{i-2}+\sqrt{\beta_{i-1}}z_{i-1})+\sqrt{\beta_i}z_i=\dots$
- $\alpha_i=\prod_{\tau=1}^i \sqrt{1-\beta_\tau}$ , 即 $\log \alpha_i=\sum_{\tau=1}^i \log\sqrt{1-\beta_\tau}$
- $\sigma_i=\sqrt{1-\prod_{\tau=1}^i (1-\beta_\tau)}$
- 得到$\alpha_i^2+\sigma_i^2=1$
- $x_i=\sqrt{1-\beta_i}x_{i-1}+\sqrt{\beta_i}z_i=\sqrt{1-\beta_i}(\sqrt{1-\beta_{i-1}}x_{i-2}+\sqrt{\beta_{i-1}}z_{i-1})+\sqrt{\beta_i}z_i=\dots$
- DDPM对应的限制, $\alpha_i^2+\sigma_i^2=1$
- 记 $\bar \alpha_i=\alpha_i^2$
- SMLD Markov chain to Marginal Distribution
- $x_i=x_{i-1}+\sqrt{\sigma_i^2-\sigma_{i-1}^2}z_i=x_{i-2}+\sqrt{(\sigma_i^2-\sigma_{i-1}^2)+(\sigma_{i-1}^2-\sigma_{i-2}^2)}\cdot z=\dots=x_0+\sigma_i\cdot z$
- SMLD对应的限制, $\alpha_i=1$
- SMLD to DDPM conversion:
- $\bar \alpha_i = \frac{1}{\sigma_i^2+1}$, $\bar x_i=\frac{x_i}{\sqrt{\bar \alpha_i}}=\sqrt{\sigma_i^2+1}\cdot x_i$
- 从 DDPM有$\frac{x_i}{\sqrt{\bar \alpha_i}}=x_0+\sqrt{\frac{1}{\bar \alpha_i}-1}z_i$ , 使$x_i$ 和$x_0$ 的mean相同
- 和SMLD $x_i=x_0+\sigma_i\cdot z_i$ 对照可得
- $\bar \alpha_i = \frac{1}{\sigma_i^2+1}$, $\bar x_i=\frac{x_i}{\sqrt{\bar \alpha_i}}=\sqrt{\sigma_i^2+1}\cdot x_i$
- Markov chain to SDE:
- $x_i=\frac{\alpha_i}{\alpha_{i-1}}x_{i-1}+\sqrt{\sigma_i^2-\frac{\alpha_i^2}{\alpha_{i-1}^2}\cdot \sigma_{i-1}^2}\cdot z_{i-1}$ $\implies$ $x_i-x_{i-1}=(\frac{\alpha_i}{\alpha_{i-1}}-1)x_{i-1}+\sqrt{\sigma_i^2-\frac{\alpha_i^2}{\alpha_{i-1}^2}\cdot \sigma_{i-1}^2}\cdot z_{i-1}$
- LHS: $x_i-x_{i-1}\rightarrow dx$
- RHS: $(\frac{\alpha_i}{\alpha_{i-1}}-1)x_{i-1}+(\sigma_i^2-\frac{\alpha_i^2}{\alpha_{i-1}^2}\cdot \sigma_{i-1}^2)\cdot z_{i-1} \rightarrow (\frac{1}{\alpha}\frac{\alpha_i-\alpha_{i-1}}{dt})xdt +\sqrt{\frac{\sigma_i^2-\frac{\alpha_i^2}{\alpha_{i-1}^2}\cdot \sigma_{i-1}^2}{dt}}\cdot dw\rightarrow (\frac{1}{\alpha_t}\frac{d\alpha_t}{dt})xdt +\sqrt{\alpha_t^2\frac{d}{dt}(\frac{\sigma_t}{\alpha_t})^2}\cdot dw\rightarrow \frac{d\log \alpha_t}{dt}xdt +\sqrt{2\alpha_t\sigma_t\frac{d}{dt}(\frac{\sigma_t}{\alpha_t})}\cdot dw$
- $x_i=\frac{\alpha_i}{\alpha_{i-1}}x_{i-1}+\sqrt{\sigma_i^2-\frac{\alpha_i^2}{\alpha_{i-1}^2}\cdot \sigma_{i-1}^2}\cdot z_{i-1}$ $\implies$ $x_i-x_{i-1}=(\frac{\alpha_i}{\alpha_{i-1}}-1)x_{i-1}+\sqrt{\sigma_i^2-\frac{\alpha_i^2}{\alpha_{i-1}^2}\cdot \sigma_{i-1}^2}\cdot z_{i-1}$
- Marginal Distribution to Markov Chain:
- $x_i=\alpha_i x_0+\sigma_i z_i$ , $x_{i-1}=\alpha_{i-1}x_0+\sigma_{i-1}z_{i-1}$
- 解出$x_{i-1}\rightarrow x_{i}$ 的变换, $x_i=\frac{\alpha_i}{\alpha_{i-1}}x_{i-1}+\sqrt{\sigma_i^2-\frac{\alpha_i^2}{\alpha_{i-1}^2}\cdot \sigma_{i-1}^2}\cdot z_{i-1}$
- stochastic Process to continuous
- ${1,2,\dots,N, \dots} \rightarrow [0,1]$ , 采样间隔为$\frac{1}{N}$
- stochastic Process to SDE.
- 利用 $x_t\rightarrow x_{t+\Delta t}$ 的积分:
- $x_{t+\Delta t}=\alpha_{t+\Delta t}x_0+\sigma_{t+\Delta t} z_{t+\Delta_t}$
- $x_t\rightarrow x_{t+\Delta t}$: $x_{t+\Delta t}=x_t+f(t)x_t\Delta t + g(t) \sqrt{\Delta t}\cdot z=(1+f(t)\Delta t)(\alpha_t x_0+\sigma_t z_t)+g(t) \sqrt{\Delta t}\cdot z_{\Delta t}=(1+f(t)\Delta t)\alpha_t x_0+\sqrt{(1+f(t)\Delta t)^2\sigma_t^2+g(t)^2\Delta t}\cdot z$
- $\alpha_{t+\Delta t}=(1+f(t)\Delta t)\alpha_t$ $\implies$ $f(t)=\lim_{\Delta t\rightarrow 0} \frac{\frac{\alpha_{t+\Delta t}}{\alpha_t}-1}{\Delta t}=\frac{1}{\alpha_t}\lim_{\Delta t\rightarrow 0} \frac{\alpha_{t+\Delta t}-\alpha_t}{\Delta t}=\frac{1}{\alpha_t}\frac{d\alpha_t}{dt}=\frac{d\log \alpha_t}{dt}$
- $\sigma_{t+\Delta t}=\sqrt{(1+f(t)\Delta t)^2\sigma_t^2+g(t)^2\Delta t}$ $\implies$ $g(t)=\lim_{\Delta t\rightarrow 0} \sqrt{\frac{\sigma_{t+\Delta t}^2-(\frac{\alpha_{t+\Delta t}}{\alpha_t})^2\sigma_t^2}{\Delta t}}=\sqrt{2\alpha_t\sigma_t\frac{d}{dt}(\frac{\sigma_t}{\alpha_t})}$
- 利用 $x_t\rightarrow x_{t+\Delta t}$ 的积分:
Reverse Diffusion Process
除Markov Chain reverse外, 其他方法的step都不需要按照forward process的schedule
- Markov Chain reverse: 由Bayes’ rule ,$p(x_{i-1}\vert x_i,x_0) = p(x_i\vert x_{i-1})\frac{p(x_{i-1}\vert x_0)}{p(x_i\vert x_0)}$ 得到
- DDPM: $x_{i-1}=\frac{\sqrt{1-\beta_i}(1-\bar \alpha_{i-1})}{1-\bar \alpha_i}\cdot x_i+\frac{\beta_i\sqrt{\bar \alpha_{i-1}}}{1-\bar\alpha_i}\cdot D(x_i,\sigma_i)+\sqrt{\beta_i\frac{1-\bar\alpha_{i-1}}{1-\bar\alpha_i}}z$
- 其中$D(x_i,\sigma_i)$ 为网络对$x_0$ 的估计值(denoised)
- $1-\beta_i=\frac{\alpha_i^2}{\alpha_{i-1}^2}=\frac{\bar \alpha_i}{\bar \alpha_{i-1}}$ (根据diffusion process, $\beta_i,\alpha_i,\bar \alpha_i$ 都可以互相得到)
- 在DDPM原论文中, 网络估计$x_i=\sqrt{\bar\alpha_i}x_0+\sqrt{1-\bar\alpha_i}z_i$ 中的$z_i$ , 记为$\epsilon$ (noise)
- 此时reverse的公式替换为 $x_{i-1}=\frac{1}{\sqrt{1-\beta_i}}(x_i-\frac{\beta_i}{\sqrt{1-\bar\alpha_i}}\cdot \epsilon)+\sqrt{\beta_i\frac{1-\bar\alpha_{i-1}}{1-\bar\alpha_i}}z$
- 另外, 如果diffusion process由SMLD得到, 由$\bar x_i, \bar \sigma_i, D(\bar x_i,\bar \sigma_i)$ 表示
- $\bar \alpha_i=\alpha_i^2=\frac{1}{\bar \sigma_i^2+1}$ , $\bar x_i=\frac{x_i}{\sqrt{\bar \alpha_i}}=\sqrt{\bar \sigma_i^2+1}\cdot x_i$ (see diffusion process 6 DDPM to SMLD)
- $\epsilon=\frac{x_i-\sqrt{\bar \alpha_i}\cdot D(x_i;\sigma_i)}{\sqrt{1-\bar{\alpha_i}}}=\frac{\frac{x_i}{\sqrt{\bar \alpha_i}}-D(x_i;\sigma_i)}{\sqrt{\frac{1}{\bar \alpha_i}-1}}=\frac{\bar x_i-D(\bar x_i;\bar \sigma_i)}{\bar \sigma_i}$ 是网络对$z_i$ 的估计值
- 随机项$z$ 的系数是$\sqrt{\beta_i\frac{1-\bar\alpha_{i-1}}{1-\bar\alpha_i}}$ 或 $\sqrt{\beta_i}$ 在实验中差别不大
- SMLD: $x_{i-1}=\frac{\sigma_{i-1}^2}{\sigma_i^2}\cdot x_i+(1-\frac{\sigma_{i-1}^2}{\sigma_i^2})\cdot D(x_i,\sigma_i)+\sqrt{\frac{\sigma_{i-1}^2(\sigma_i^2-\sigma_{i-1}^2)}{\sigma_i^2}}\cdot z$ , 即$x_{i-1}=x_i-\frac{\sigma_i^2-\sigma_{i-1}^2}{\sigma_i}\cdot \epsilon+\sqrt{\frac{\sigma_{i-1}^2(\sigma_i^2-\sigma_{i-1}^2)}{\sigma_i^2}}\cdot z$
- $D(x_i,\sigma_i)$ 和$\epsilon$ 和DDPM里面含义一样
- DDPM: $x_{i-1}=\frac{\sqrt{1-\beta_i}(1-\bar \alpha_{i-1})}{1-\bar \alpha_i}\cdot x_i+\frac{\beta_i\sqrt{\bar \alpha_{i-1}}}{1-\bar\alpha_i}\cdot D(x_i,\sigma_i)+\sqrt{\beta_i\frac{1-\bar\alpha_{i-1}}{1-\bar\alpha_i}}z$
- Marginal Distribution reverse: 沿用Markov Chain reverse中 $x_{i-1}=\kappa x_i+\lambda x_0+\sigma z$ 的假设, 但是去掉$p(x_i\vert x_{i-1})$ 的依赖
- general: $x_{i-1}=\frac{\sqrt{\sigma_{i-1}^2-\sigma^2}}{\sigma_i}\cdot x_i + (\alpha_{i-1}-\frac{\alpha_i\sqrt{\sigma_{i-1}^2-\sigma^2}}{\sigma_i})\cdot D(x_i,\sigma_i)+\sigma z$
- $\alpha_{i-1}x_0+\sigma_{i-1}z_{i-1}=x_{i-1}=\kappa(\alpha_i x_0+\sigma_i z_i)+\lambda x_0+\sigma z=(\kappa\alpha_i+\lambda)x_0+\sqrt{\kappa^2\sigma_i^2+\sigma^2}\cdot z$
- 比较LHS和RHS, $x_0$ 和$z$ 的系数可得$\kappa, \lambda$ 关于$\sigma$ 的表达式
- 比Markov Chain reverse多一个参数$\sigma$
- $\alpha_{i-1}x_0+\sigma_{i-1}z_{i-1}=x_{i-1}=\kappa(\alpha_i x_0+\sigma_i z_i)+\lambda x_0+\sigma z=(\kappa\alpha_i+\lambda)x_0+\sqrt{\kappa^2\sigma_i^2+\sigma^2}\cdot z$
- DDPM: 令$\alpha_i=\sqrt{\bar \alpha_i}$ , $\sigma_i=\sqrt{1-\bar \alpha_i}$ , $\sigma=\sqrt{\beta_i\frac{1-\bar\alpha_{i-1}}{1-\bar\alpha_i}}$ 得到和Markov Chain reverse相同形式(see diffusion process 3)
- DDPM的另一种尝试: $\sigma=\sqrt{\beta_i}$
- 可以和DDPM效果类似
- DDPM的另一种尝试: $\sigma=\sqrt{\beta_i}$
- SMLD: 令$\alpha_i=1, \sigma=\sqrt{\frac{\sigma_{i-1}^2(\sigma_i^2-\sigma_{i-1}^2)}{\sigma_i^2}}$ 可得(see diffusion process 5)
- DDIM: $x_{i-1}=\frac{\sigma_{i-1}}{\sigma_i}\cdot x_i+(\alpha_{i-1}-\alpha_i\frac{\sigma_{i-1}}{\sigma_i})\cdot D(x_i,\sigma_i)$ , 即 $x_{i-1}=\frac{\alpha_{i-1}}{\alpha_i}( x_i-(\sigma_i-\frac{\alpha_{i}}{\alpha_{i-1}}\sigma_{i-1})\cdot \epsilon)$
- 令$\sigma=0$ , 此时reverse process是一个确定的过程(implicit的含义)
- general: $x_{i-1}=\frac{\sqrt{\sigma_{i-1}^2-\sigma^2}}{\sigma_i}\cdot x_i + (\alpha_{i-1}-\frac{\alpha_i\sqrt{\sigma_{i-1}^2-\sigma^2}}{\sigma_i})\cdot D(x_i,\sigma_i)+\sigma z$
- SDE reverse:
- general: $dx=(f(t)\cdot x-\frac{1}{2}g^2(t)\nabla_x\log p(x,t))dt+g(t)dw$
- $g(t)^2=2\alpha_t\sigma_t\frac{d}{dt}(\frac{\sigma_t}{\alpha_t})$
- $\nabla_x\log p(x;t)\approx (D(x;\sigma)-x)/{\sigma}^2$
- SMLD: $dx=\dot\sigma_t \frac{x-D(x_t,\sigma_t)}{\sigma_t}\cdot dt+\sqrt{2\dot \sigma_t \sigma_t}dw$
- gradient $\frac{dx}{dt}=\dot\sigma_t \frac{x-D(x_t,\sigma_t)}{\sigma_t}$
- 做变量替换得, $\frac{dx}{d\sigma}=\frac{x-D(x_\sigma,\sigma)}{\sigma}=\epsilon$ (在gradient based method 例如Euler, Heun中用到)
- general: $dx=(f(t)\cdot x-\frac{1}{2}g^2(t)\nabla_x\log p(x,t))dt+g(t)dw$
- Probability flow ODE: (see [3] Appendix D.) $dx=(f(x,t)-\frac{1}{2}g^2(t)\nabla_x\log p(x,t))dt$
- SDE和Probability flow ODE有相同的marginal probability density $p_t(x)$
- SMLD: $dx=\dot\sigma_t \frac{x-D(x_t,\sigma_t)}{\sigma_t}\cdot dt=\dot\sigma_t \epsilon(x_t,\sigma_t)\cdot dt$
- $x_{i-1}=x_i+\int_{t_i}^{t_{i-1}} \sigma_\tau\epsilon(x_\tau,\sigma_\tau)\cdot \frac{\dot\sigma_\tau}{\sigma_\tau}\cdot d\tau=x_i-\int_{\lambda_i}^{\lambda_{i-1}} e^{-\lambda_\tau}\epsilon(x_{\tau_\lambda},\sigma_{\tau_\lambda}) d\lambda$ (DPM-solver中用到)
- 记$\lambda_\tau=-\log \sigma_\tau$ , $\sigma_\tau=e^{-\lambda_\tau}$
- $\epsilon$ 是通过网络得到的不能直接积分, 所以需要一些方法近似
- $x_{i-1}\approx x_i -\int_{\lambda_i}^{\lambda_{i-1}} e^{-\lambda_\tau} \sum_{n=0}^{k-1} \frac{(\lambda-\lambda_i)^n}{n!}\epsilon^{(n)}(x_i,\sigma_i) d\lambda= x_i -\sum_{n=0}^{k-1} \epsilon^{(n)}(x_i,\sigma_i) \int_{\lambda_i}^{\lambda_{i-1}} e^{-\lambda_\tau} \frac{(\lambda-\lambda_i)^n}{n!} d\lambda$
- k对应DPM-Solver的阶数
- DPM-Solver-1: k=1 时, 正是Euler-method
- $x_{i-1}=x_i-\epsilon\int_{\lambda_i}^{\lambda_{i-1}}e^{-\lambda_\tau}d\lambda=x_i-\epsilon\cdot(e^{-\lambda_i}-e^{-\lambda_{i-1}})=x_i-\epsilon\cdot(\sigma_{i}-\sigma_{i-1})$ 正好和DDIM $\alpha_i=1$ 时的表达式重合
- $x_{i-1}=x_i+\int_{t_i}^{t_{i-1}} \sigma_\tau\epsilon(x_\tau,\sigma_\tau)\cdot \frac{\dot\sigma_\tau}{\sigma_\tau}\cdot d\tau=x_i-\int_{\lambda_i}^{\lambda_{i-1}} e^{-\lambda_\tau}\epsilon(x_{\tau_\lambda},\sigma_{\tau_\lambda}) d\lambda$ (DPM-solver中用到)
reference
[1] Ho, Jonathan, Ajay Jain, and Pieter Abbeel. “Denoising Diffusion Probabilistic Models.” arXiv:2006.11239 [Cs, Stat], December 16, 2020. http://arxiv.org/abs/2006.11239. DDPM原作者版本
[2] Song, Jiaming, Chenlin Meng, and Stefano Ermon. “Denoising Diffusion Implicit Models.” arXiv, October 5, 2022. https://doi.org/10.48550/arXiv.2010.02502. DDIM
[3] Song, Yang, Jascha Sohl-Dickstein, Diederik P. Kingma, Abhishek Kumar, Stefano Ermon, and Ben Poole. “Score-Based Generative Modeling through Stochastic Differential Equations.” arXiv, February 10, 2021. https://doi.org/10.48550/arXiv.2011.13456. DDPM, SMLD, SDE, ODE
[4] 苏剑林. (Aug. 03, 2022). 《生成扩散模型漫谈(五):一般框架之SDE篇 》[Blog post]. Retrieved from https://spaces.ac.cn/archives/9209 和系列里面其他文章
[5] 代码: https://github.com/comfyanonymous/ComfyUI/blob/master/comfy/k_diffusion/sampling.py https://github.com/comfyanonymous/ComfyUI/blob/master/comfy/samplers.py