
数据
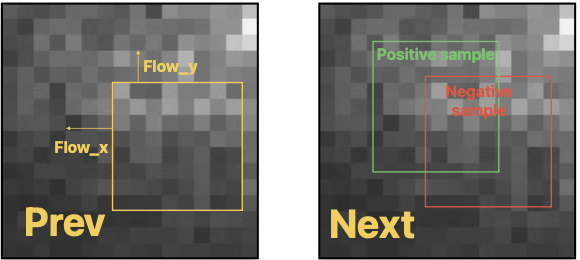
① ② : 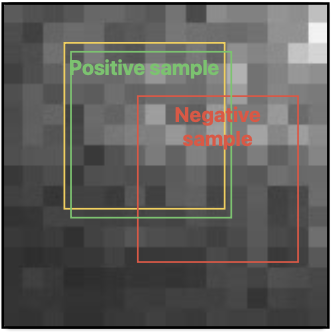 ③ :
| 采样方式 | 具体说明 | 特点 | |
|---|---|---|---|
| ① | 仿真图像+仿真采样 Sample |
在16x16的图像上随机crop得到8x8的patch, 再随机用grid_sample提取8x8的patch比对 正样本: 和patch距离<0.5的patch |
从采样方法来说, 当前像素只和周围3x3邻域像素相关 |
| ② | 真实图像+仿真采样 SampleFromFrame |
用实际sensor提供的图片 | |
| ③ | 真实图像+真实采样 SampleFromVideo |
筛选实际sensor提供的图片前后帧, 用其他算法确定光流已知的图片对, 在图片的其他区域采样 |
这是图像配准特征训练中的一般做法 |
- 代码: local_binary.py
- 结果: 对于究竟学到了哪方面特征, 我很疑惑
- 出乎我意料的, 是① > ② > ③
- 可能是我加噪声的方式和真实情况有差距?
- 可能是我数据采样中的光流不可靠?
- 可能是产生了我不清楚的过拟合?
- adaboost的方法比神经网络训练效果好(或者差不多?)
- “最好”的训练结果也没比不训练的结果(sad-mean(diff)的版本)好.
- 可能通过匹配patch计算光流的准确度本来已经达到饱和, 再训练patch的描述也没法提升?
- 用真实数据的loss比仿真数据要大
- 说明真实数据更难
- 用真实图像插值时, 结果变得超差, 改成crop好了一些
- 出乎我意料的, 是① > ② > ③
torch grid sample
torch grid 的采样方式有align_corners=True和align_cornes=False两种
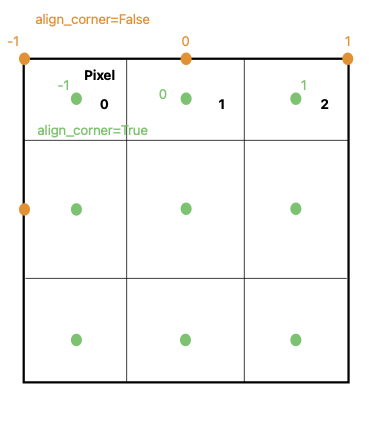
- 转换关系: 一般需要对齐的时候选align_corner=True
- pixel -> grid(align_corner=True):
x=x/(n-1)*2-1 - x和y的dim可能和crop也不一致, 需要注意
- 可以先按转换关系使grid_sample和crop完全对齐, 测试sample代码位置上是否正确
- pixel -> grid(align_corner=True):
gradient descent训练
用对比学习的模式, 输入相同size的dist(N x M: batch_size x compared_sample_num)和 label.
- label = 1, 对应match pair, 我们想要使其dist更小(相关性的话更大)
- 对batch的dim做平均要在最后, 因为不同sample应该分别排序
几种contrastive loss
| loss | 公式 | 目的 | 特点 | |
|---|---|---|---|---|
| AP Loss (Average Precision) 按照R2D22的写法 |
1. 把dist量化, 变为N x Q x M 的binary tensor 2. 和label比对, 统计每个sample对应的match/miss的hist: N x Q 3. 对于hist的每个bin, 计算前面k个bin的precision prec@k=cumsum_k match/(match+miss) 4. 对每个bin位置的prec@k 做关于match hist的加权平均, 得到AP 5. AP loss = 1-mean(AP) |
减小miss hist排在match hist前面的情况 用prec@K 表示混合程度 名称里的average, 是对match sample的average 说是precision, 代码里实际写的是accuracy |
要根据dist范围调整量化的min/max 量化的过程用到了clamp截断 因为所有的正样本都参与了训练 这个loss会比较稳定 在训练过程中, hist本身就是一个很直观观测分布的指标 |
|
| InfoNCE (Noise-Contrastive Estimation) |
1. 对dist做softmax 2. 计算dist和label的cross entropy loss |
让match dist=0, miss dist = 1 | 要保证batch的每个sample只对应一个正样本 (因为softmax) |
|
| triple loss | 1. 每个batch sample, 分别选取match sample里dist最大(ap), 和miss sample里dist最小的(an) 2. 计算这两者的ranking loss 即 $dist_{ap}-dist_{an}-m$ (m是boundary, 即允许最大的match dist比最小的miss dist稍大一点) |
让match dist尽量小, miss dist尽量大 | 只有最极端的正负样本参与了训练 | |
| Circle Loss | 1. 对match sample(sp), 和miss sample(sn)做logsumexp 2. 对这两个加和做soft_plus 参数$\gamma$ 控制logsumexp的光滑度, 参数m还是控制match/miss的dist界限值 |
和triple loss差不多, 但是是连续形式 | 其他正负样本也参与训练, 越是bad case权重越高 |
- 代码: loss.py
- 当时写的时候我用的是相关性而不是dist(但是变量名写的是dist…), 可能是改r2d2代码的时候糊涂了 💔(代码里在量化的时候把相关性转成了dist)
- AP_loss的中间结果(dist的平均分布):
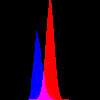 其中蓝色是match, 红色是miss
- 光流任务 :
- 尝试了两种descriptor:
- 只用AP loss和64dim的 linear特征loss比较正常
- 如果用grid-sample 选一些pixel pair的差值(类似BRIEF ), loss完全没有下降
- dist计算中, 如果是用内积计算两组sample(N x V, M x V)的相关性(N x M), 只需要用矩阵乘法就可以. 但是如果用其他自定义的dist, 需要先extend到(N x M x V, N x M x V), 去计算距离.
- 尝试了两种descriptor:
Adaboost训练
如果特征是离散的, gradient没有指导意义的时候, 可以用sample+选择的方式训练
- 特征采用BRIEF binary特征, 每个pixel pair做为一个weak-learner
- $h = sign(p_1-p_2)$
- 步骤是重复: 选特征-> 更新sample权重 -> 计算weighted error 的过程
- 代码: boosting_train.py
adaboost的一个改进
在beblid2中介绍了给每个weak-learner加一个boundary的方法: 当weak-learner结果在boundary的同侧视为匹配(比如 $h_1<T, h_2<T$ ), 异侧视为不匹配
- 步骤: 对于每个weak-learner
- 给当前weak-learner的结果排序
- 先确定当前weak-learner所对应的可能的boundaries ${T_j}$
- $T_{j-1}$ 到 $T_j$ error的改变有以下几种可能: 假设$(v_1,v_2)$ 是当前weak-learner sample pair的结果
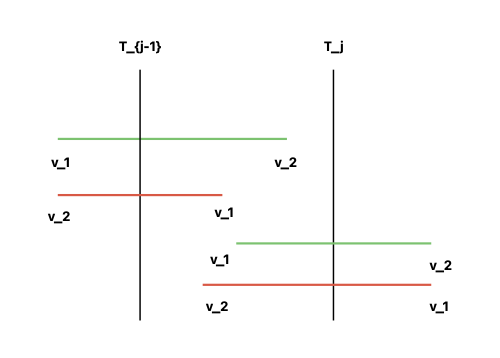
- $v_1< T_{j-1}<v_2< T_{j}$ , $v_1, v_2$ 从$T_{j-1}$ 的异侧变为了$T_j$ 的同侧 (1)
- 如果$(v_1, v_2)$ label为1, match, error -1
- 如果$(v_1, v_2)$ label为-1, miss, error +1
- $T_{j-1}<v_1< T_{j}<v_2$ , $v_1, v_2$ 从$T_{j-1}$ 的同侧变为了$T_j$ 的异侧 (2)
- 如果$(v_1, v_2)$ label为1, match, error +1
- 如果$(v_1, v_2)$ label为-1, miss, error -1
- $v_2< T_{j-1}<v_1< T_{j}$ , $v_1, v_2$ 从$T_{j-1}$ 的异侧变为了$T_j$ 的同侧 (3)
- 如果$(v_1, v_2)$ label为1, match, error -1
- 如果$(v_1, v_2)$ label为-1, miss, error +1
- $T_{j-1}<v_2< T_{j}<v_1$ , $v_1, v_2$ 从$T_{j-1}$ 的同侧变为了$T_j$ 的异侧 (4)
- 如果$(v_1, v_2)$ label为1, match, error +1
- 如果$(v_1, v_2)$ label为-1, miss, error -1
- 用 $d_1$ 收集case 2,3, $d_2$ 收集case 1,4.
- 当$v_1$ 经过$T_{j-1}\rightarrow T_j$ 就会触发$d_1$, 当$v_2$ 经过$T_{j-1}\rightarrow T_j$ 就会触发$d_2$
- $T_{j-1}$ 到 $T_j$ error的改变有以下几种可能: 假设$(v_1,v_2)$ 是当前weak-learner sample pair的结果
- 遍历boundrary $T_j$ 和其中的sample即可计算出全部带boundary的weak-learner的error
- 计算量:
- 如果是plain的adaboost, 每个weak-learner的迭代只需要更新weight, 计算量只有O(N)
- 如果weak-learner总数很多, 每次迭代只sample一部分weak-learner, 就没法复用weak-learner的结果, 要重新计算O(N x W)
- W 是本轮重新sample出的weak-learner
- 如果给weak-learner附上boundary, 还要
- 对每个weak-learner的结果排序O(PlogP), P=2N 是sample pair里结果的个数, 即O(W x PlogP)
- 对每个weak-learner遍历sample 的结果 O(N), 即O(W x N)
- 如果不是采用这种遍历sample的方式, 虽然不需要排序了, 但是需要O(T x N)的error计算, 即总共O(W x T x N), 考虑到sample数N是比较大的, 这没法接受
- 考虑在boundary同侧的结果本来就没影响, 所以拆成排序+遍历应该是boundary训练的一个常见的方法🤔️
- 因为每个weak-learner的结果和boundary的选择不一样, 似乎没法在weak-learner那边并行❓
opencv的人脸检测分类器也是这种加boundary(threshold)的形式
reference
[1] He, Kun, Yan Lu, and Stan Sclaroff. “Local Descriptors Optimized for Average Precision.” arXiv, April 17, 2018. http://arxiv.org/abs/1804.05312.
[2] Revaud, Jerome, Philippe Weinzaepfel, César De Souza, Noe Pion, Gabriela Csurka, Yohann Cabon, and Martin Humenberger. “R2D2: Repeatable and Reliable Detector and Descriptor.” arXiv, June 17, 2019. https://doi.org/10.48550/arXiv.1906.06195.
[3] Suárez, Iago, Ghesn Sfeir, José M. Buenaposada, and Luis Baumela. “BEBLID: Boosted Efficient Binary Local Image Descriptor.” Pattern Recognition Letters 133 (May 2020): 366–72. https://doi.org/10.1016/j.patrec.2020.04.005.
其他资源
[1] https://www.htmlsymbols.xyz/number-symbols/circled-numbers html特殊list符号
[2] https://www.zhihu.com/question/382802283 很好的对于Circle loss的解释