
在token很多(大模型用的超长文本), 或者本身数据是时间序列(比如语音, 视频流)的情况下, attention里面的weight会带来$O(token^2)$ 的内存消耗. state space model可以解决这个问题.
基本结构
SSM(state space model)
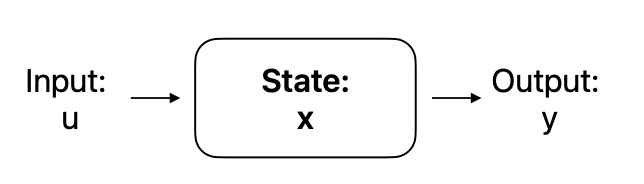
- 状态空间(state space) : 用state vector记录历史的input, 而不是记录所有的历史token
- 连续表示:
- linear state space model的一般形式:
- $\dot x(t)=A(t)x(t)+B(t)u(t)$ (用input u更新状态 x)
- $y(t)=C(t)x(t)+D(t)u(t)$ (用状态x, 生成output y)
- 如果A,B,C是time invariant, 以及省略D, 得到,
- $\dot x(t)=Ax(t)+Bu(t)$
- 解得 $x(t)=e^{At}x(0)+\int^t_0 e^{A(t-\tau)}Bu(\tau)d\tau$ , $x(t)$ 是$u(t)$ 的卷积形式: $x(t)=K(t)*u(t)$, $K(t)=e^{At}B$
- $y(t)=Cx(t)$
- $\dot x(t)=Ax(t)+Bu(t)$
- linear state space model的一般形式:
- 离散表示:
- 迭代的表示: $x_{k+1}=\bar A x_k + \bar Bu_k$ , $y_{k+1}=Cx_{k+1}$
- 用Zero order hold 离散表示$u(t)$ , $\Delta$ 是step_size, 有: $\bar A=e^{\Delta A}$ , $\bar B=(\Delta A)^{-1}(e^{\Delta A}-I)\cdot \Delta B$
- Discretization wiki中正好有这个推导
- 用blinear离散表示$u(t)$, $\Delta$ 是step_size, 有: $\bar A=(I-\Delta/2\cdot A)^{-1}(I+\Delta/2\cdot A)$ , $\bar B=(I-\Delta/2\cdot A)^{-1}\cdot \Delta B$
- 用Zero order hold 离散表示$u(t)$ , $\Delta$ 是step_size, 有: $\bar A=e^{\Delta A}$ , $\bar B=(\Delta A)^{-1}(e^{\Delta A}-I)\cdot \Delta B$
- 卷积的表示: $y=x * \bar K$ , $\bar K = (C\bar B, C\bar{AB}, \dots, C\bar A^{N-1}\bar B)$
- 迭代的表示: $x_{k+1}=\bar A x_k + \bar Bu_k$ , $y_{k+1}=Cx_{k+1}$
- 一些状态空间的应用:
- Kalman filter
- control theory
- 特点:
- 迭代和卷积的形式完全等价, 一般在训练时用卷积形式方便计算并行, 在推理时用迭代形式节省时间和存储
- 对于很多任务, 输入$u(t)$ 是多通道的, 这个时候一般把相同ssm应用在每个通道上
- SSM支持无限长的序列推理, 所有的历史token信息都被压缩到state里
Linear Attention
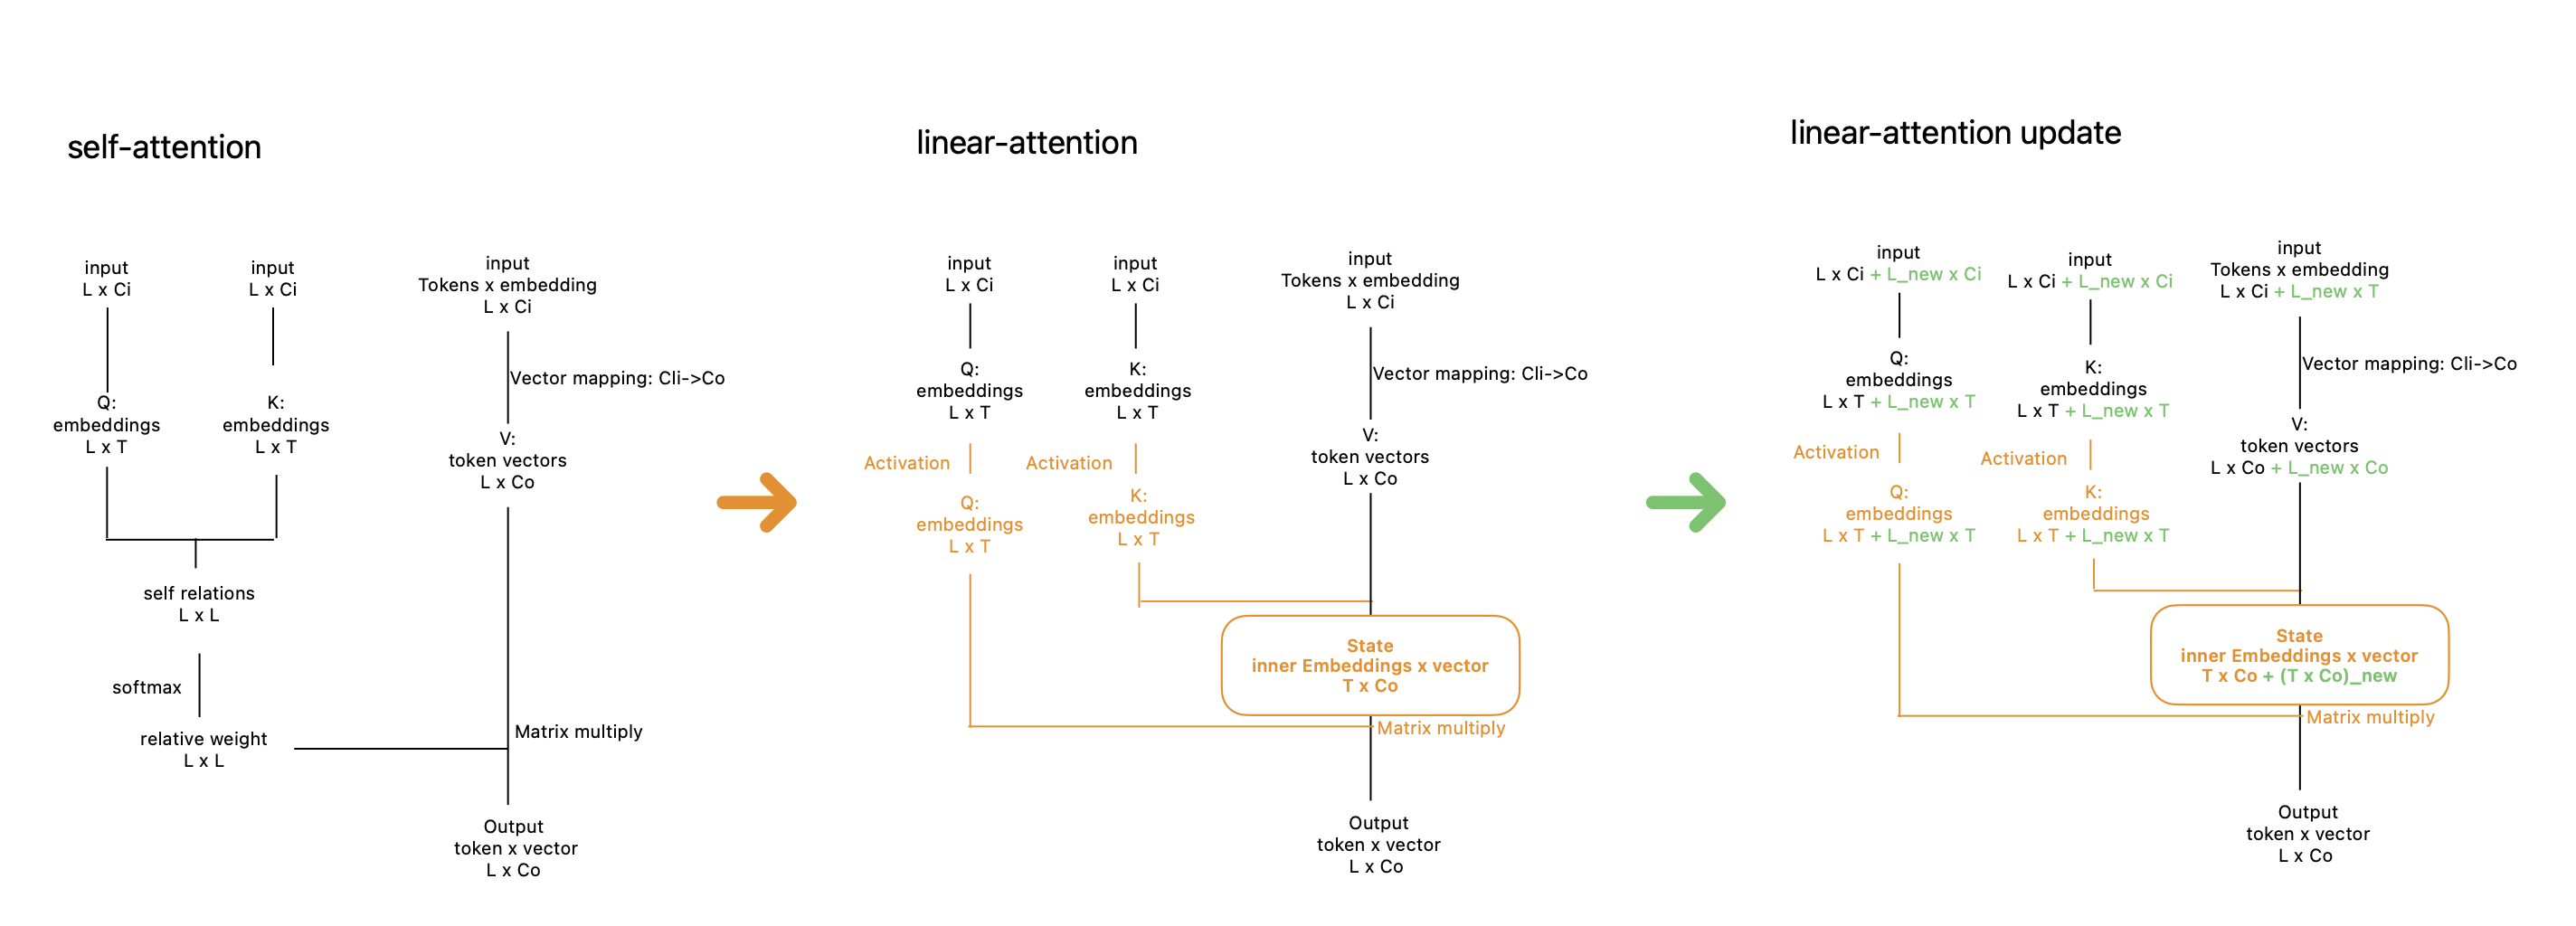
- 把self-attention的softmax换掉就可以改写成SSM的形式, 既有SSM计算节省内存和时间的优点, 又贴近self-attention的效果
- 按照这种写法, 可以把SSM迭代中的$B, C$ 写成$K, Q$
- 实际使用中发现, linear attention的state容量是有限度的, 虽然理论上支持无限长的token, 但是对历史信息的遗失不好处理, 效果远不如基于self-attention的方法
一些利用SSM/linear attention的语言模型工作
S4(Structured state space sequence) 结构
发现用HiPPO(High-order Polynomial Projection Operator)矩阵做为SSM 中的状态转移矩阵$A$ 的初始化可以极大的提高SSM的性能.
- motivation:
- 在measure function $\omega^{(t)}$ 下, 用一组orthogonal basis表示有限维的state $x$ (例如: Legendre polynomials $P_n^{(t)}$ , $x(t)=\sum_n c_n(t)*P_n^{(t)}$)
- 在measure function $\omega^{(t)}$ 下, 想从state $x$ 尽量恢复出input $u$ 的历史信息 $u_{\le t}$ , 即
\(x=\text{argmin}_{c_n}||u_{\le t}-\sum_n c_n*P_n||_{\omega}\)
- measure function的选择影响了我们在state $x$ 中保留什么样的历史信息: 例如 $\downarrow$
- LegS(scaled Legendre measure), $\omega(t)=\mathbb{1}[0,t]/t$ 对历史信息权重平均, 保留$\le t$ 的所有历史信息
- LegT(Translated Legendre), $\omega(t)=\frac{1}{\theta} \mathbb 1[t-\theta,t]$ , 保留最近一段的信息
- measure function的选择影响了我们在state $x$ 中保留什么样的历史信息: 例如 $\downarrow$
- 计算:
- 以上两点得出, $c_n$ 是$u_{\le t}$ 在basis $P_n$, measure $\omega$ ,下的projection, $c_n=<u_{\le t}, P_n^{(t)}>_{\omega}$ ,
- 即 \(x=\sum_n <u_{\le t}, P_n^{(t)}>_{\omega} P_n^{(t)}=proj_{(\omega, P_n^{(t)})} (u_{\le t})\)
- 如果写成SSM卷积的形式, \(x=K*u\) , \(K(t)=\sum_n P_n^{(t)}*\omega^{(t)}\)
- 因为$P_n$ 本身是basis: $\dot P_n\in span(P_n)$, 我们选取的$\omega$ 也尽量满足: $\dot \omega\in span(\omega)$
- 把 $x$ 和 $u$ 带入SSM的ODE( $\dot x(t)=Ax(t)+Bu(t)$ ), 即得到Hippo矩阵 $A(t)$ , 和 $B(t)$
- 在计算过程中为了方便会做一些变量替换
- 对于LegS的情况, $A(t)$ 不是time-invariant的, 不过, 可以写成 $A(t)=\frac{1}{t}A$ 的形式
- S4的结构里用的是没有$\frac{1}{t}$ 的版本, 可以对应$w(t)=e^{-t}$ 和 $p_n(t)=L_n(e^{-t})$ . 按文章里的说法, 是实验有效之后才反过来找到对应的basis和measure🤔️
- 以上两点得出, $c_n$ 是$u_{\le t}$ 在basis $P_n$, measure $\omega$ ,下的projection, $c_n=<u_{\le t}, P_n^{(t)}>_{\omega}$ ,
这个恢复信号的想法和VAE里面用latent space压缩图像信号的想法很相似.
H3(Hungry Hungry Hippos) 结构
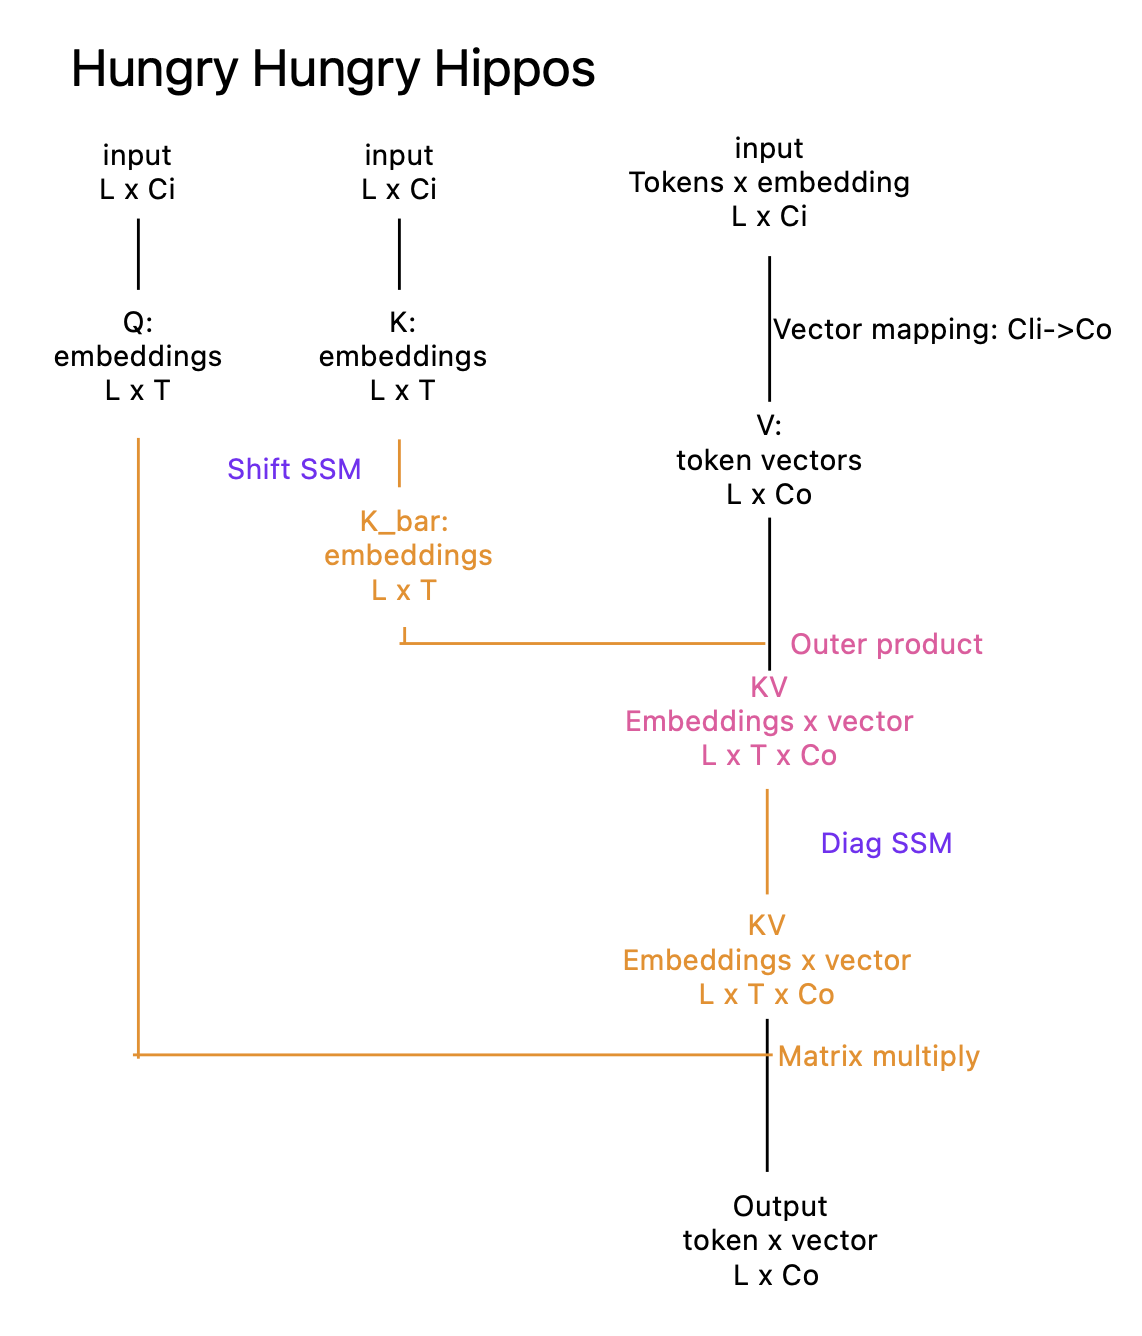
- 和linear attention不同, H3里面KV并没把不同token的信息加在一起, 整个结构里, 不同token的信息只在SSM的地方进行交互
- SSM模块: 这两个SSM模块是为了语言模型精心设计的
- 其中Shift SSM指SSM中的状态转移矩阵$A$ 是个shift matrix , 有 $A^k=0$ 的特点, 距离和当前token大于k的信息被自然的刷新, 在网络中用于记录较近的索引
- 代码: https://github.com/HazyResearch/H3/blob/main/src/models/ssm/ss_kernel_shift.py
- Diag SSM指转移矩阵$A$是diagonal matrix, 保存全局记忆, 已经记录的信息不会随着新输入token刷新
- 其中Shift SSM指SSM中的状态转移矩阵$A$ 是个shift matrix , 有 $A^k=0$ 的特点, 距离和当前token大于k的信息被自然的刷新, 在网络中用于记录较近的索引
- 视频 里详细讲解了h3结构和associatve recall的任务(输入一个dict, 提问某个key对应的value)的关系: 也是我第一次知道q,k,v的名字和任务的联系
RetNet
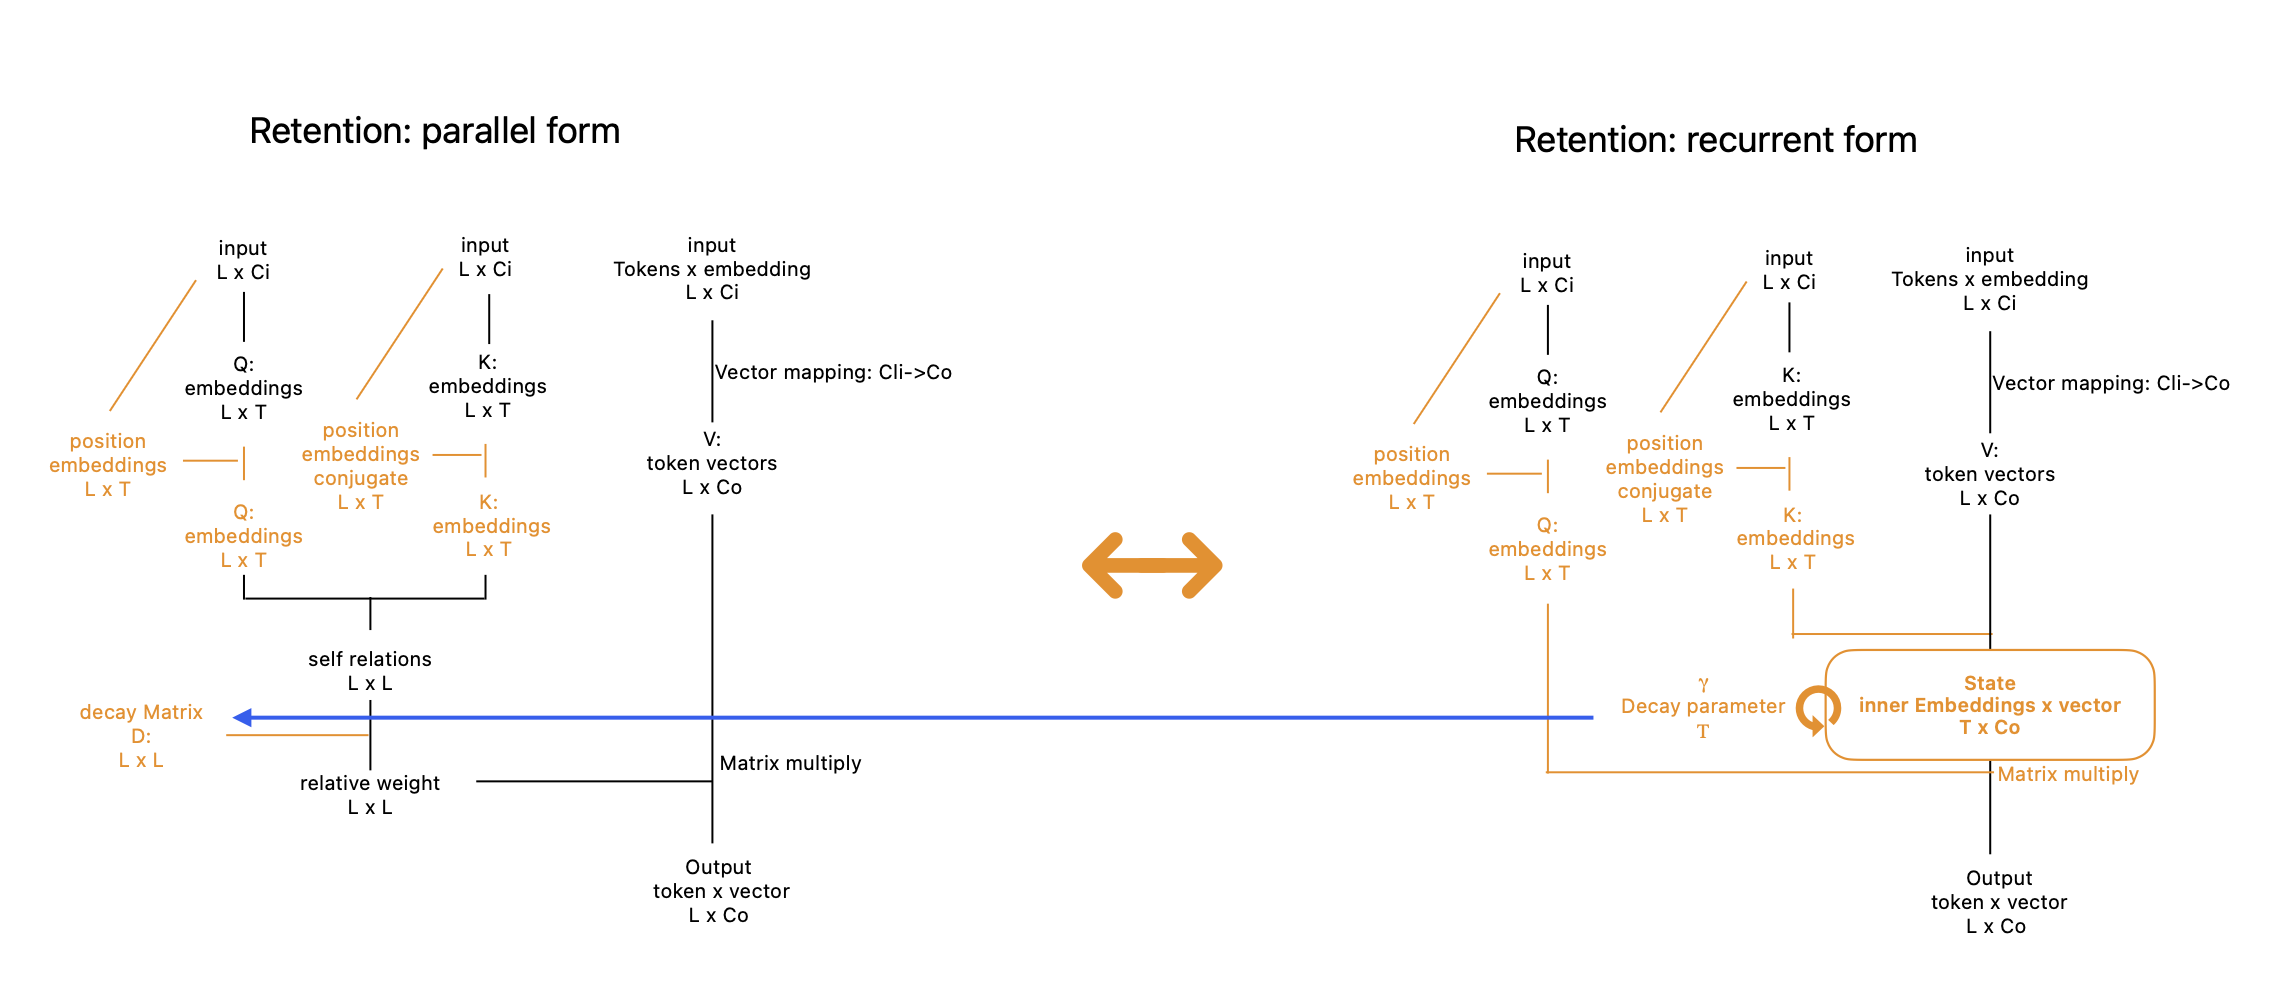
- 在linear-attention的基础上增加了state的状态转移, 是对linear attention的一个巧妙的变形.
- 试图用position embedding和D矩阵的exponential decay代替attention里的softmax的功能
- Rentention的代码 写的很清晰
RWKV
- time-mixing和channel-mixing两个模块交替: 代码
- time-mixing是一个类linear attention的结构, 配一个特殊设计的state转移(也就是文章里的WKV operator)
- 这么设计state转移的动机, 我是不明白
- channel-mixing是分成两路, 分别做 conv(token window_size=2) + linear + activation
- time-mixing是一个类linear attention的结构, 配一个特殊设计的state转移(也就是文章里的WKV operator)
- RWKV做了配套的chat的很多相关代码工作
Mamba
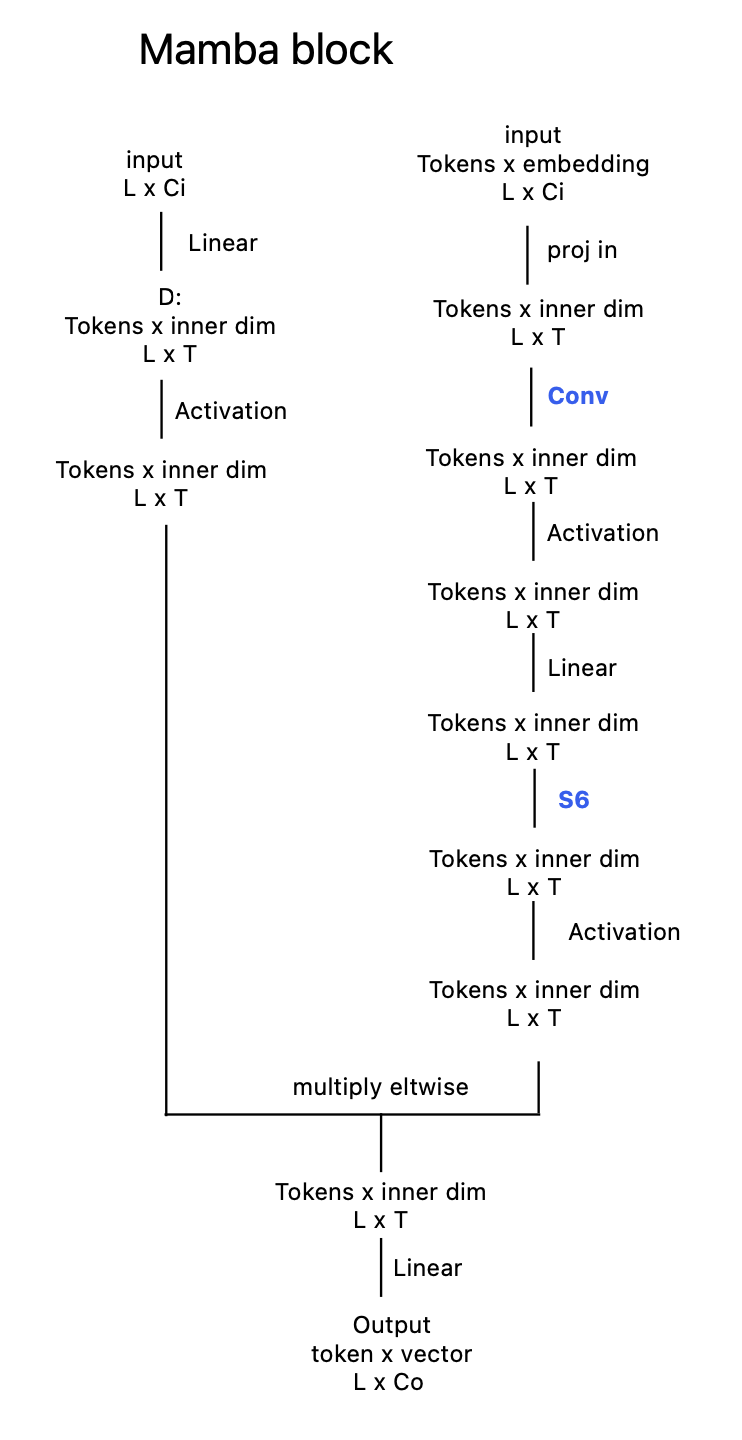
- 基础的SSM模块改为S6(Selective S4)模块: 把SSM离散表示中$\Delta, B, C$ 改成time-variant. 以适应不同位置的信息密度.
- 我觉得这种想法和deformable convolution的想法类似, 都是对一些结构parametrize.
- Mamba block:
- 用convolution和S6, 而不是attention进行信息交互.
- 基于mamba block的大模型用更少的参数达到了和基于attention的大模型类似的效果.
- 最近有一些文章用mamba block魔改去做视觉任务? 没有特别了解但是感觉很奇怪, 因为SSM本身有个顺序的结构…在视觉任务上这个顺序要怎么定义?
reference
[1] Katharopoulos, Angelos, Apoorv Vyas, Nikolaos Pappas, and François Fleuret. “Transformers Are RNNs: Fast Autoregressive Transformers with Linear Attention.” arXiv, August 31, 2020. https://doi.org/10.48550/arXiv.2006.16236.
[2] Gu, Albert, Karan Goel, and Christopher Ré. “Efficiently Modeling Long Sequences with Structured State Spaces.” arXiv, August 5, 2022. http://arxiv.org/abs/2111.00396. (S4)
[3] Gu, Albert, Tri Dao, Stefano Ermon, Atri Rudra, and Christopher Re. “HiPPO: Recurrent Memory with Optimal Polynomial Projections.” arXiv, October 22, 2020. https://doi.org/10.48550/arXiv.2008.07669.
[4] Gu, Albert, Isys Johnson, Aman Timalsina, Atri Rudra, and Christopher Ré. “How to Train Your HiPPO: State Space Models with Generalized Orthogonal Basis Projections.” arXiv, August 5, 2022. http://arxiv.org/abs/2206.12037.
[5] Fu, Daniel Y., Tri Dao, Khaled K. Saab, Armin W. Thomas, Atri Rudra, and Christopher Ré. “Hungry Hungry Hippos: Towards Language Modeling with State Space Models.” arXiv, April 28, 2023. https://doi.org/10.48550/arXiv.2212.14052.
[6] Sun, Yutao, Li Dong, Shaohan Huang, Shuming Ma, Yuqing Xia, Jilong Xue, Jianyong Wang, and Furu Wei. “Retentive Network: A Successor to Transformer for Large Language Models.” arXiv, August 9, 2023. https://doi.org/10.48550/arXiv.2307.08621.
[7] Peng, Bo, Eric Alcaide, Quentin Anthony, Alon Albalak, Samuel Arcadinho, Stella Biderman, Huanqi Cao, et al. “RWKV: Reinventing RNNs for the Transformer Era.” arXiv, December 10, 2023. https://doi.org/10.48550/arXiv.2305.13048.
[8] Gu, Albert, and Tri Dao. “Mamba: Linear-Time Sequence Modeling with Selective State Spaces.” arXiv.org, December 1, 2023. https://arxiv.org/abs/2312.00752v1.
其他讨论的链接
[1] https://blog.csdn.net/v_JULY_v/article/details/134923301
[2] https://github.com/state-spaces/s4/issues/40 作者对hippo的答疑
[3] https://www.youtube.com/watch?v=TkOSKrlpnU4&t=716s H3作者的讲解
[3] https://www.zhihu.com/question/602564718/answer/3042600470 RWKV的知乎讨论
[4] https://cloud.tencent.com/developer/article/2377967 Mamba block的理解