和inpaint一样要利用stable-diffusion的图生图功能, 想让图像忠于原图的情况下提升图像细节, 解决图像模糊, 扭曲, 不合理的部分.
使用
- 模型:
- 一般模型: 对于模糊的图, encode+ksample+decode就可以提升细节
- StableSR: 基于sd2.1, 关于细节修复任务重新训练的模型
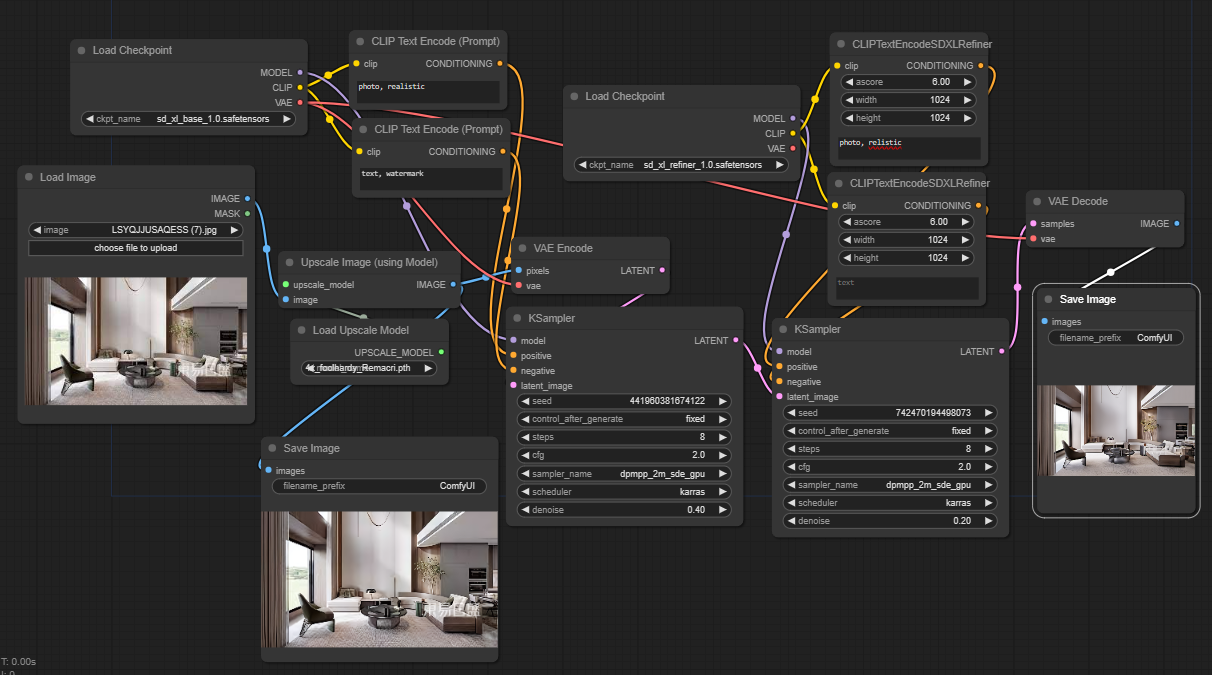
- sdxl refiner模型: 输入latent image, 官方建议接在sdxl base模型的后面用
- sdxl refiner一般只能配和sdxl base模型, 不能配合其他风格的sdxl模型, 所以不是很实用
- 控制:
- 更像原图:
- 风格控制: 和inpaint一样, 可以用text promt和ipadpater控制
- 微调模型控制:
- controlnet tile(配合v1.5模型): 这是个非常好用的模型👍, 可以在分块(输入的不是一整张图)的时候, 更倾向理解图像部分而不是text prompt
- 关于sdxl模型没有一个tile模型的讨论
- 提升细节:
- 从流程上控制:
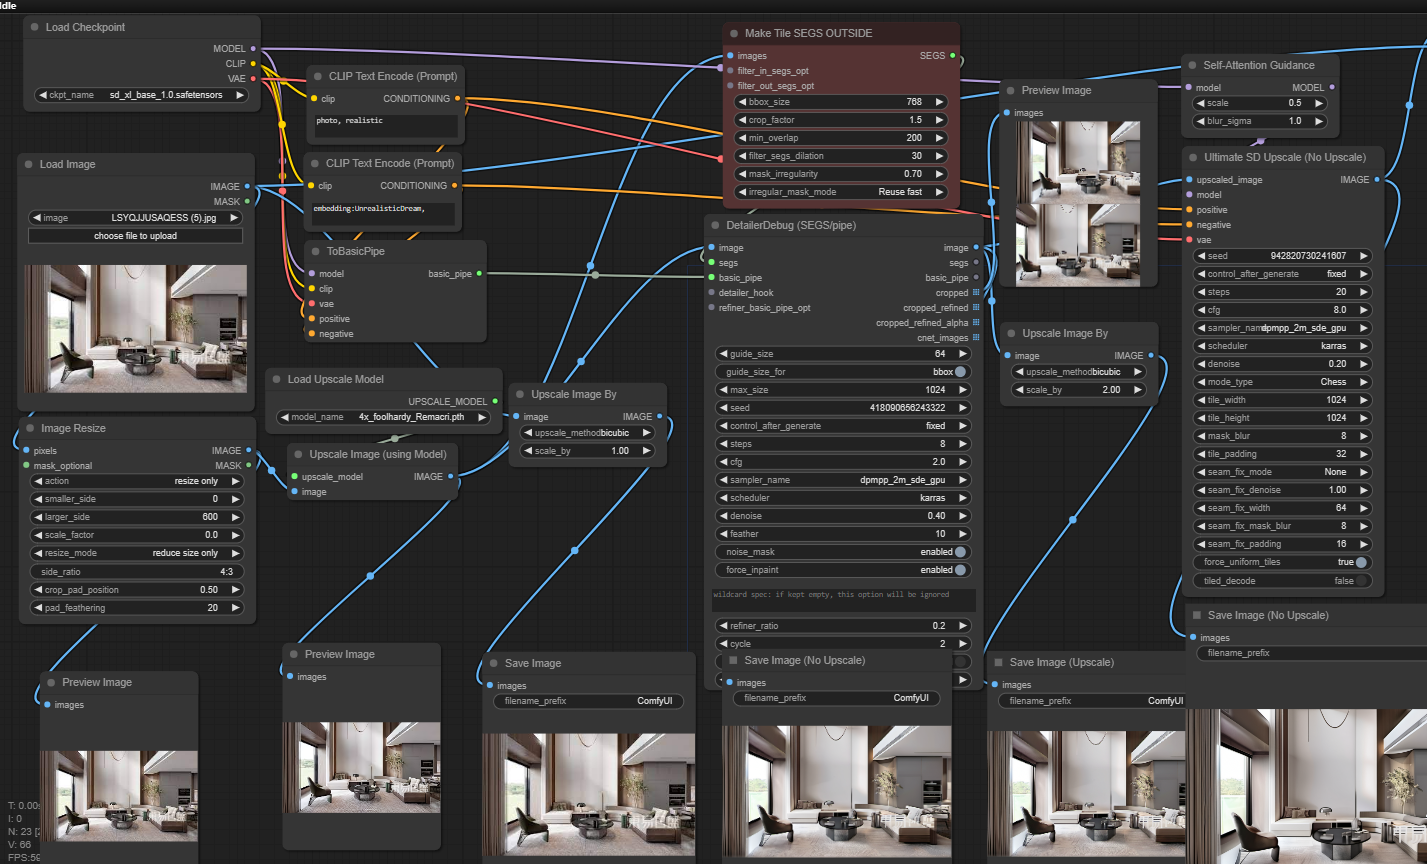
- Self-attention Guidance(SAG)
- 和cfg(class free guidance)类似, 是更改reverse diffusion process的过程
- 让图片变清晰原理: 认为self-attention值更大的位置是更重要的位置, 让其离blurry的方向更远, 即更清晰
- 从文章里的例子看, 这种做法达成了一种神奇的自纠正的效果, 可能是因为在reverse diffusion process中重要的地方更快的变清晰, 引导了其他部分的生成
- Self-attention Guidance(SAG)
- 从流程上控制:
- 更像原图:
- 方便的节点: stable-diffusion本身的图生图功能input和output等大的, 图像大小和模型不匹配的时候就需要分块处理或放大
- 分块: 下面两个功能类似
- ComfyUI Impact Pack 提供的detailer节点 : 包含一些方便的功能
- 可以分块图生图
- 可以设置cycle次数, 即图生图的次数 (如果comfyUI本身提供循环功能就好了)
- UltimateSDUpscale
- 支持分块图生图
- 改变tile的一些融合方式
- ComfyUI Impact Pack 提供的detailer节点 : 包含一些方便的功能
- 放大: 放大经常伴随细节损失, 一般是和refine功能接力使用: upscale->refine->upscale->refine->upscale->refine…
- 我看到有人在latent image上放大, 总感觉这么做不对, latent image的一个点大约对应图像8x8的patch, 放大latent后这个比例关系和放大图像是不一样的
- 分块: 下面两个功能类似
效果
- 使用时要注意:
- 输入图像的尺寸: 如果输入图像太小也是无法生成正常图片的, 尽量用外部的resize和upscale调整到和模型训练的大小相近
- 图像包含的语义信息的尺寸
- reverse diffusion process的参数: cfg, denoise, steps等
- 对一些常见的噪声效果很好, 例如: jpg压缩的高频alias, 摩尔纹
- 但是对于其他噪声就不认识, 可能被认作图像本身的风格?
- 例如我用其他prior搭配admm算法恢复图像的中间结果
- 汉字也会被改变的看不出形状
- 用相机拍摄的失焦和运动模糊的图片尝试, 效果非常差
- 但是对于其他噪声就不认识, 可能被认作图像本身的风格?
- 恢复出的图像风格会受选择的主要模型风格影响, 很难保证细节不变风格还原
- 恢复真实人物的效果很差, 可能是本身我们对人脸细节要求就更严格? 可能需要加载专门控制人脸的微调模型
ComfyUI workflow
用sdxl的refiner$\downarrow$ : refine_sdxl_refiner.json
用detailer节点和 UltimateSDUpscale 节点$\downarrow$ : refine_impact_pack_detailer_SAG_UltimateSD.json