
用SAM抠图
以下两种方式都是对segment-anything二次封装
- 在ComfyUI里用segment anything节点
- 特点: 任何shape都可以, 输入text prompt, 但是没法输入位置
- 步骤:
- groundingDINO模型: image, text prompt->目标检测box
- SAM模型: image, box-> mask
- SAM模型本体可以接受多种形式的prompt
- SAM模式的特点是对image只encode一次, 这里box是作为prompt形式输入的, 不是在图像上crop然后处理cropped image
- 🤔️: SAM本来就可以输入text prompt, 加入groundingDINO模型是因为SAM的text promt效果不好吗?
- inpaint-anything
- 特点: 输入point prompt和text prompt(optional), 对输入图像大小有要求, 还接入了一个stable-diffusion的inpaint模块
inpainting & outpainting & guided
- 图生图功能: 利用stable-diffusion的sampler流程, noise mask之外的部分网络就不会去更改, 利用VAE decoder的填补能力
- VAE encode成latent: 根据情况选择图像输入
- 输入原图: 直接用VAE Encode->latent->Set Latent Noise Mask->Ksampler
- 适合想保留部分原图元素的
- 输入用灰色填补mask的图: 用 VAE Encode(for inpainting) ->latent->Ksampler
- VAE Encode(for inpainting) 相当于 用灰色mask的图VAE Encode + Set Latent Noise Mask 两个节点的效果
- 适合想要在mask处新生成物体的
- 输入自制引导图: 直接用VAE Encode->latent->Set Latent Noise Mask->Ksampler
- 适合想要引导图上的一些元素的: 形状, 布局, 颜色等
- 输入LaMa inpaint的图: 用fooocus comfyUI版本 提供的inpaint from model节点, 然后再走VAE Encode->latent->Set Latent Noise Mask->Ksampler的流程
- 一定要用GrowMask加大mask的范围(最好把图像中受物体影响的部分全mask掉,例如mask人物的影子, 或是被挡住一半的文字. 不要留下不和谐的部分. 3 )
- 适合有重复pattern的场景效果
- 输入原图: 直接用VAE Encode->latent->Set Latent Noise Mask->Ksampler
- 用 Set Latent Noise Mask 在做sampler的流程中对mask以外的地方进行保留
- sdxl模型latent image可以对应到8x8的pixel patch, 输入的mask会resize到latent大小成为latent mask
- VAE encode成latent: 根据情况选择图像输入
- 控制: inpainting任务是想让生成的部分风格接近原图, 和原图边界融合的更好
- 用ipadapter控制风格
- ipadapter会参考原图物体的位置关系, 使这个控制在outpainting里非常鸡肋, 我们的目的是生成和原图风格一致的新物体, 而不是把原来的物体叠加在图片上
- 用合适的text prompt控制+引导图可以有效的减少ipadapter对物体位置的影响, 效果非常好
- ipadapter的attention mask输入是 整张图-> 部分 的流程, 而不是我们在inpainting任务想要的 部分 -> 整张图
- attention mask可以用来把两张图融合在同一张图的不同位置, 例如让两个人合影
- ipadapter会参考原图物体的位置关系, 使这个控制在outpainting里非常鸡肋, 我们的目的是生成和原图风格一致的新物体, 而不是把原来的物体叠加在图片上
- 用text prompt控制
- WD14 Tagger 推导提示词
- 用Gemini 的API的打标功能
- 微调模型控制: 如果不加任何模型, 生成出来的结果和原图看起来完全不融合
- controlnet inpaint:(配合v1.5)
- inpaintpreprocessor输入image, mask
- inpaintpreprocessor处理过的图像输入inpaint controlnet
- controlnet连接text prompt
- 用controlnet的时候甚至可以用空的latent, 因为controlnet会更改sampler流程为生成整张图?
- 但是一般还是输入image latent 参考, 不然的话颜色风格会变奇怪
- fooocus inpaint: (配合sdxl)
- fooocus自己的ui界面做inpaint网上评价很好
- fooocus comfyUI版本的一些使用问题: README里给出的工作流都不太work
- 输入model, patch(包含一个head模型和一个lora模型), latent(必须包含latent image和noise mask)
- 使用时感觉好像一定要配合VAE Encode(for inpainting), 如果输入lama补充后的, 结果会出现奇怪的偏色, 是模型内部对mask部分进行了识别吗?
- 用fooocus 开发的dpmpp sampler方式迭代, 也会出现奇怪的东西, 是comfyui的实现有问题吗?
- controlnet inpaint:(配合v1.5)
- 用ipadapter控制风格
- 结果: 远没有达到一键生成的效果, 但是比起lama只会填入重复花纹还是有很大进步
- 新生成的部分和原图融合的不好
- 按这个流程原图mask之外的内容不会重新生成, 融合的不好可以理解, 应该是生成整张图才对. 这个工作流应该是有问题, 没有发挥stable diffusion的全部能力
- 需要修改seed多次生成(抽卡), 人工选好一点的效果做为图生图VAE部分的输入继续
- 尤其是人物, 动物, 补全的地方可以看出很明显的问题, 是多次抽卡解决不了的, 必须要配合人工实时修改
- 新生成的部分和原图融合的不好
ComfyUI workflow
换背景
工作流: inpainting_background_SAM_fooocus.json $\downarrow$
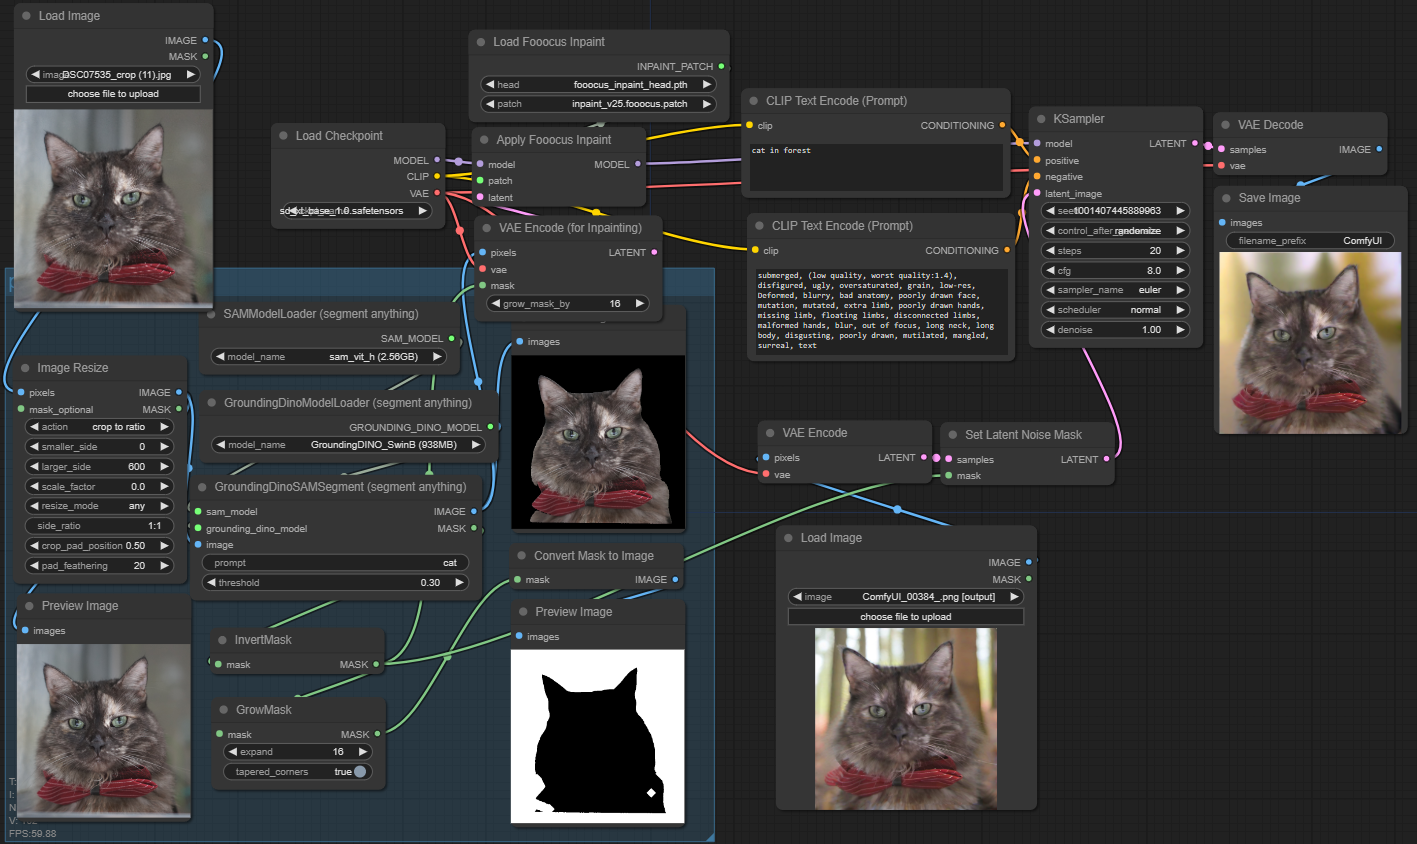
去掉不想要的人物
inpaint_delete_person_SAM_Lama_fooocus.json $\downarrow$
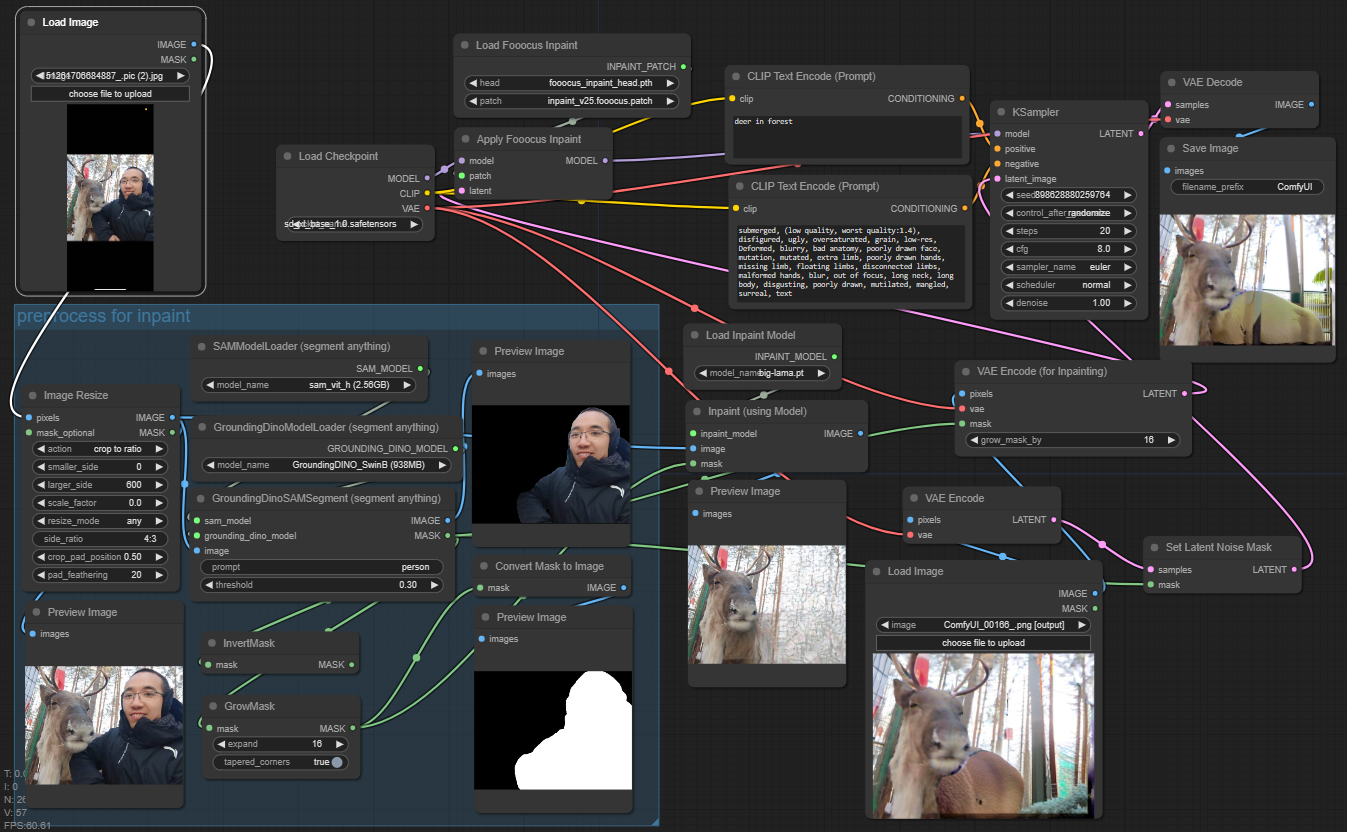
修改局部
inpaint_edit_fooocus_ipadapter.json $\downarrow$
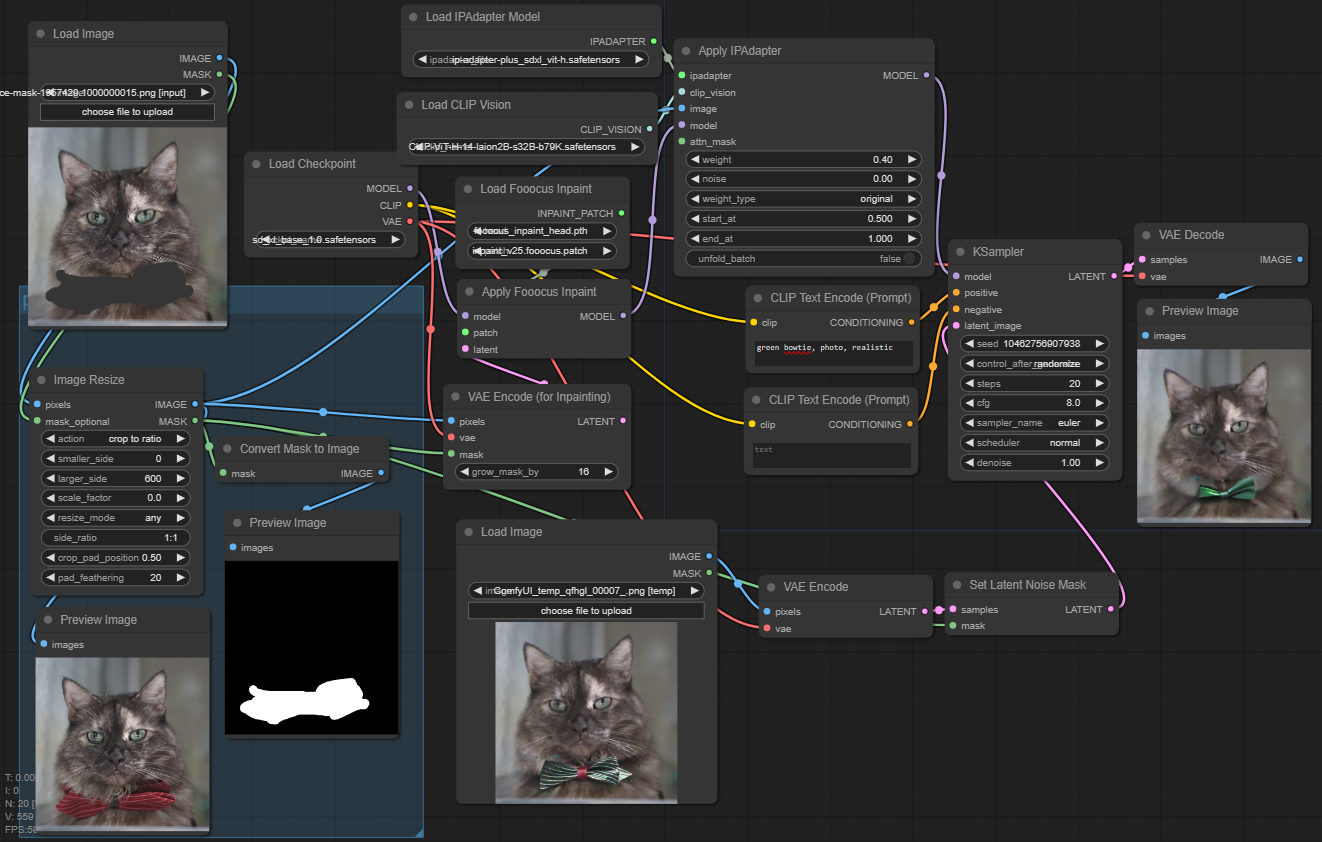
和inpaint类似, 用Pad for Outpainting生成mask和灰色填补的图像
outpaint 更改图片尺寸
outpainting_lama_fooocus_ipadapter.json $\downarrow$
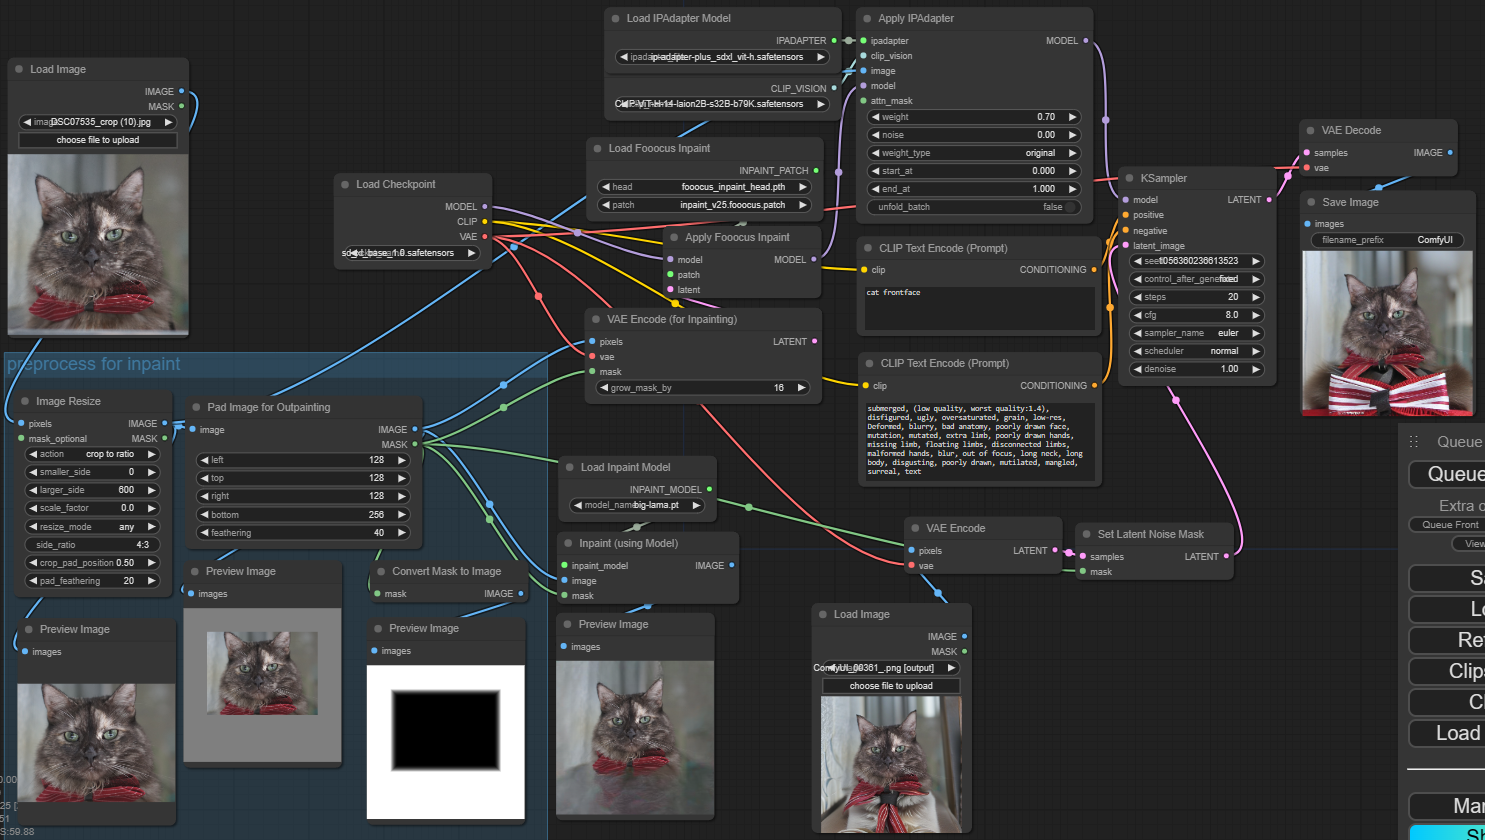
- 想生成简单纯色的背景似乎不可能, 网络总会自己加些东西: 是不是网络认为纯色背景是一种未完成的状态?
由引导图生成图片
guided_image_ipadapter_attmask.json $\downarrow$
- 参考网络上这个做法 : 生成一组边框和圆形logo
- 用到了inpaint, 图片引导, ipadapter的attmask功能
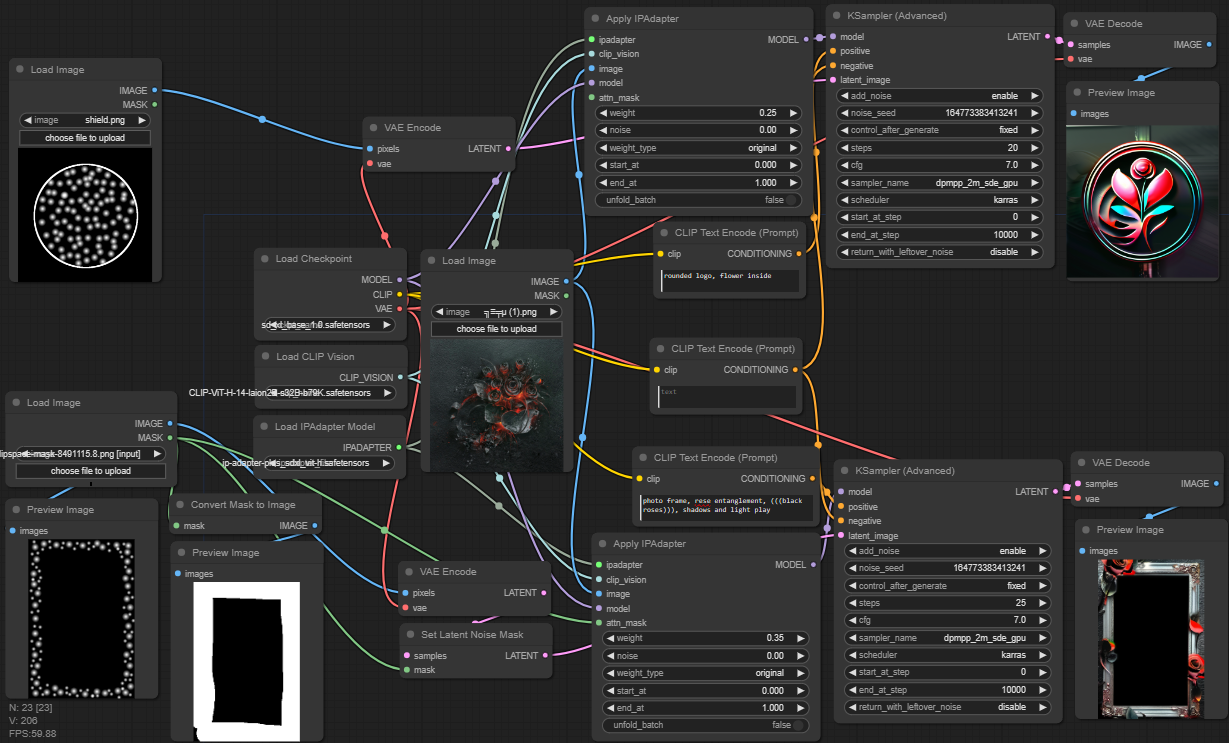
- 用引导图控制颜色的例子:
- 用引导图控制布局的例子:
注意事项
- 白色是想要网络生成的部分
- 如果在一个工作流里同时用SAM, foocus inpaint, ipadapter等模型, 我16G的显存会不够用: 其实SAM在生成mask之后就可以移出显存了, 但是不清楚comfyui怎么操作
reference
[1] https://github.com/Sanster/IOPaint inpaint+outpaint合集
[2] https://github.com/comfyanonymous/ComfyUI/blob/master/nodes.py#L331 ComfyUI 节点代码
[3] https://medium.com/gliacloud/removing-any-object-from-your-photo-with-lama-7e966765fadc lama实际使用感受
[4] https://huggingface.co/blog/TimothyAlexisVass/explaining-the-sdxl-latent-space sdxl的latent image的解释. sdxl的latent image和原图像素对应.