
在网络中, block是把input信息转换成output信息的过程: 一般, output(position, vector)是input(token, embedding vector)的线性组合, 组合的weight (position, token) 由input和output两方关系确定. 把着重强调这种信息交互的模块叫attention.
convolution
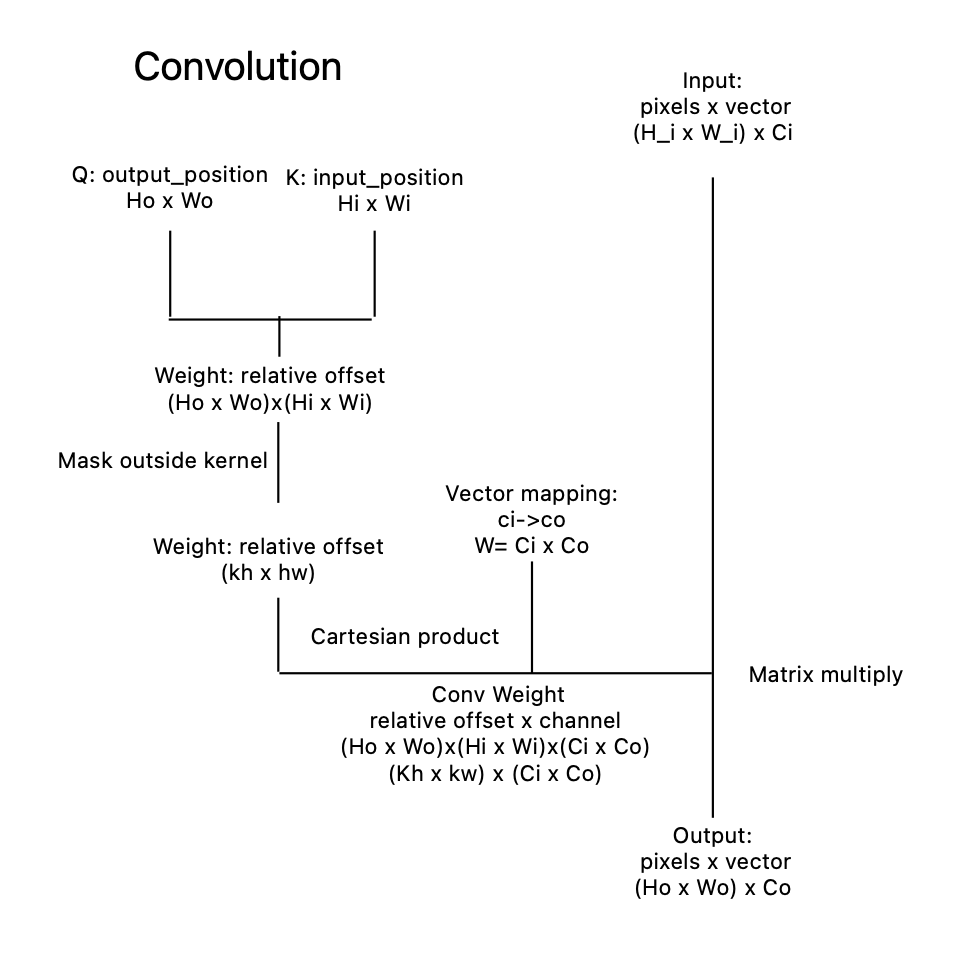
convolution在神经网络流行之前就已经在图像任务里广泛使用了
- 目的:
- 对spatial information进行特征的提取和转换
- 特点:
- pixel的weight只和(input, output)的相对位置有关, 因此也是平移不变的. 对每个输出像素有影响的只有input里kernel覆盖到的区域, 也就是response field
- 每个不同的相对位置对应vector mapping不同
- 这个符合图像处理的直观, 左边有条线和右边有条线当然要映射成不同的结果
- 有时也会把卷积拆分成1x1 conv和spatial conv(通道无关) 的形式
gate attention
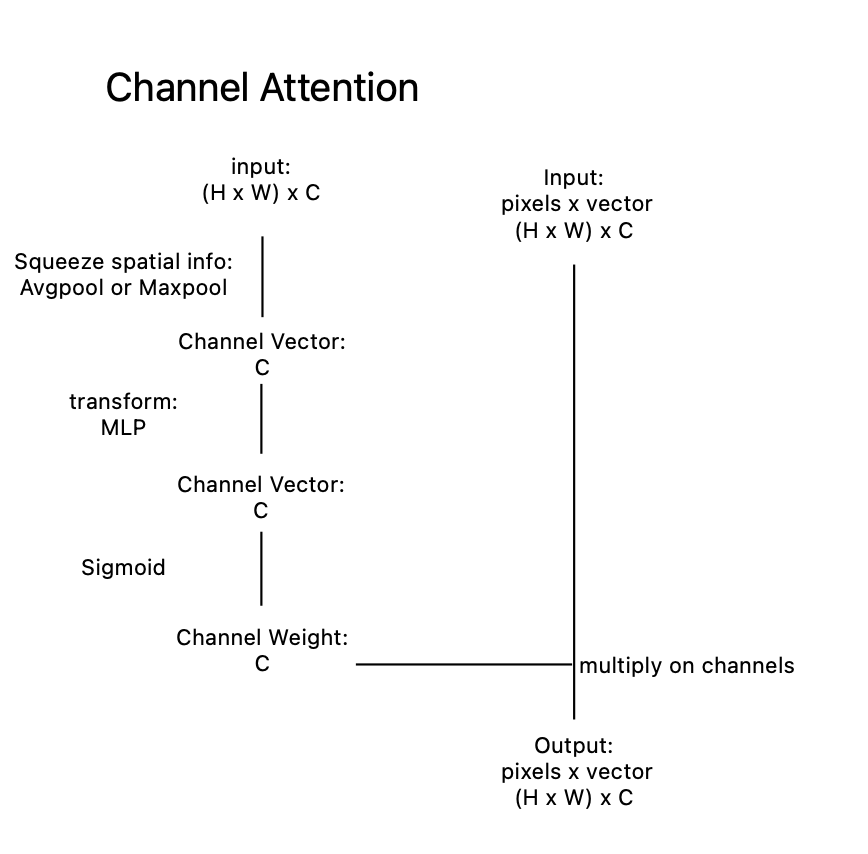
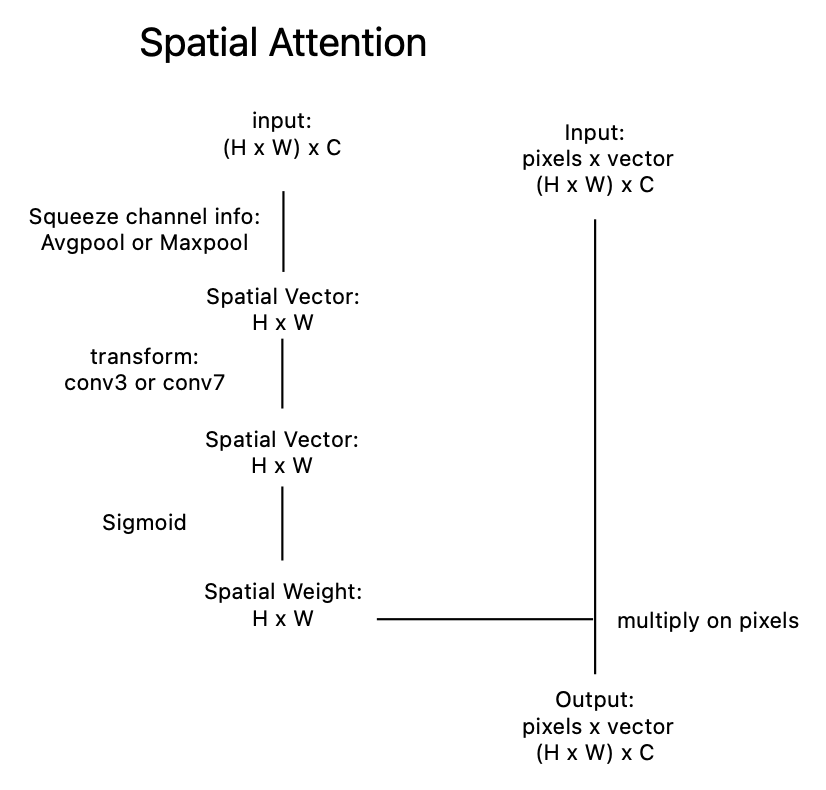
- 目的:
- 提取channel1或spatial的权重, 让网络关注更重要的信息
- 特点:
- spatial 信息对人类来说更有可读性, 所以可以把spatial weight可视化, 看看图片什么位置更加重要
self-attention & cross-attention
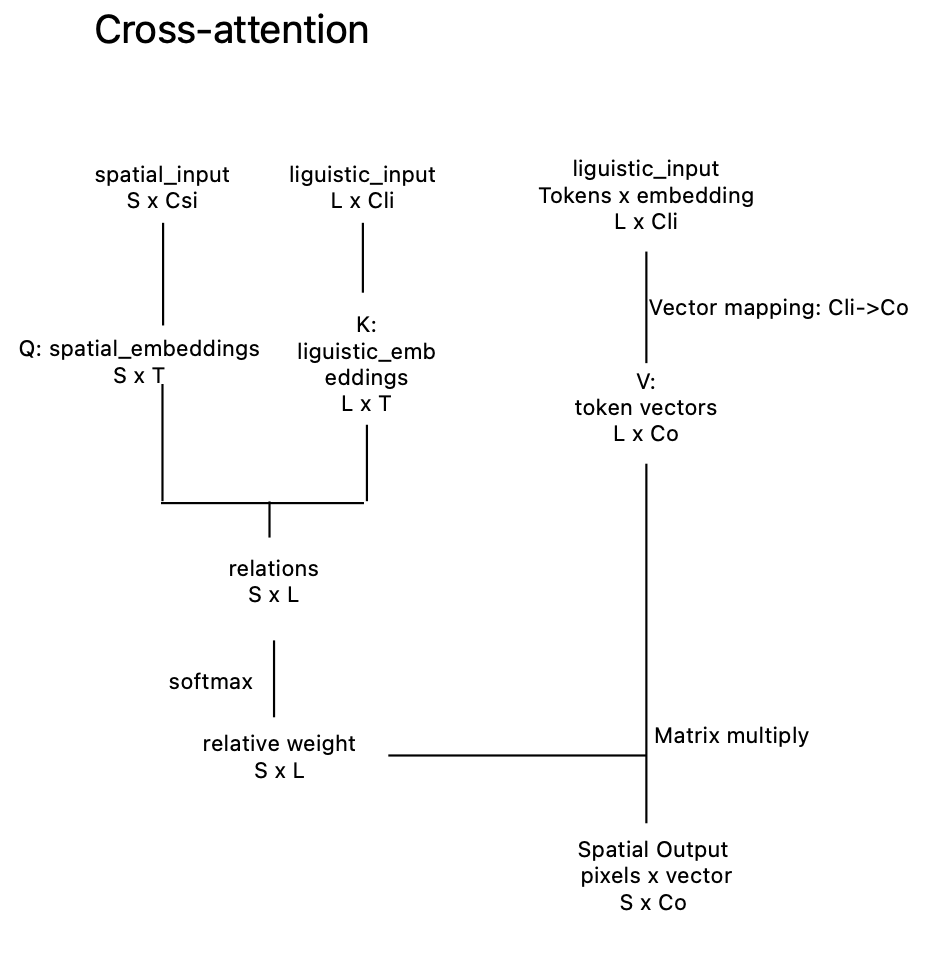
- 目的:
- 信息的交互: 在我的图示中, 是把文字信息加入视觉信息
- 特点:
- self-attention和cross-attention结构类似, 只是变成了一种输入
- cross-attention是现在常见的把一种信息加入另一种信息的方法
- 也用到了图像信息和文字信息的统一形式, 即(position, embedding) , 在图像信息中, position(S=H x W)是像素或patch的位置; 文字信息中, position是token在句中的前后位置
- relative weight:
- 我们可以对relative weight可视化, 从而知道某个文字token和图像哪个位置最相关
- 对relative weight的一个维度做average pooling, 就能知道哪个位置是更重要的4(和gate-attention的用法一样)
- Q,K,V(query, key, value) 的叫法是nlp搜索(匹配)任务的术语, 额, 其实我一直没法对这个望文生义…
- 其实从计算过程可以看出, 不管它们的原义, Q, K交换一下也没差
- query和key的embedding channel数应该相同, 为了之后计算他们relation的目的
- 和卷积不一样, 放了更大的计算量在交互部分, 相对的, 每个input token对应vector mapping相同, 也就是用”value”部分解决了channel的映射: 这样导致同样的文字信息不论放在前面还是后面, 对应同一种output信息, 区别的只是他们权重可能不同, 或在图像的不同位置
- 把position embedding预先和text embedding在成为”value”之前编码在一起可以解决这个问题
- 在文本模型里, 其实token的相对位置也很重要, 虽然不会像卷积一样relation完全由相对位置决定. 比如, 相对位置编码就把相对位置加到relation里
attention的一些变形和优化
- mulit-head attention: 映射多组QKV, 计算得到的多组output再concat
- 在实际实现过程中, 先映射成一个大的QKV, 再把Q, K, V切分是完全等价的
- 做mulit-head可以得到多组不同的映射方式, 因为两个token之间的关系可能由多种关系构成(比如猫和老鼠既可能是捕食关系, 也可能是同为宠物, 也可能同为动画片的角色)
- 分层attention: 在做attention之前对数据排序, 切分
- 可能有些pixel之间关联不大, 这样的话把它们分到不同的bucket, 分别做attention, 可以减少计算量2
- 多个attention合成:
- 在最近流行的ipadapter里面也讨论了多种不同来源的数据在cross-attention 里合成的问题, 结论是分别与原数据做attention最后再合成比较好3, 这个也是我们一般naive的想法
光流估计网络
视觉匹配任务
代码
reference
[1] Woo, Sanghyun, Jongchan Park, Joon-Young Lee, and In So Kweon. “CBAM: Convolutional Block Attention Module.” arXiv, July 18, 2018. https://doi.org/10.48550/arXiv.1807.06521. 介绍gate attention
[2] Cai, Yuanhao, Jing Lin, Xiaowan Hu, Haoqian Wang, Xin Yuan, Yulun Zhang, Radu Timofte, and Luc Van Gool. “Coarse-to-Fine Sparse Transformer for Hyperspectral Image Reconstruction.” arXiv, July 10, 2022. https://doi.org/10.48550/arXiv.2203.04845. 介绍了Spectra-aware hashing attention block的结构
[3] https://github.com/tencent-ailab/IP-Adapter
[4] Hong, Susung, Gyuseong Lee, Wooseok Jang, and Seungryong Kim. “Improving Sample Quality of Diffusion Models Using Self-Attention Guidance.” arXiv, August 24, 2023. https://doi.org/10.48550/arXiv.2210.00939.