三元运算符(ternary)解析
目标是将 DSL 中的三元运算符 ... ? ... : ... 转换为 if_else(..., ..., ...) 的函数调用形式。
初衷是用正则替换把对应DSL的operator转换成python语言, 然后用python的ast 直接解析. 但是三元运算符的处理比较复杂, Python 中并没有直接对应的语法结构, 导致没法简单的替换.
可以把字符串token解析成AST 的构建过程理解成“对运算符按优先级排序”的过程.
| 方法 | 优缺点 | 类比排序思路 | 平均复杂度 |
|---|---|---|---|
| 用正则表达式替换三元运算符 | 思路naive, 但是可读性差,难以维护 | O(n logn)+kO(n) 全字符串扫描+递归 |
|
| 设计语法树解析器(Parser) | 灵活性高, 但实现较复杂 | 选择排序 | O(n logn) 近似二分递归 |
| 结合 Pratt Parser 优化解析 | 代码简洁, 可读性高, 扩展性好 | 插入排序/堆排序 | O(n) 线性扫描 |
方案一:直接用字符串替换
- 用字符串正则查找tenary并替换
- 递归处理?: 和括号, =, 逗号的关系
- 致命缺陷:处理括号和逗号时,严重依赖外置的栈 (Stack) 状态来维系嵌套结构,代码难以维护。
方案二:手写传统 Parser 处理
通过编写自定义的解析器来自顶向下处理表达式。核心处理流程如下:
1. 前期定义
- 定义 AST 节点:设计不同类型的节点类来表示表达式,如常量、变量、运算符等。
- Tokenize(词法分析):将源代码字符串分割成 tokens(数字、运算符、字符串等)。
- 示例:
a<0.2?$\rightarrow$[("NAME","a"), ("OP","<"), ("NUMBER","0.2"), ("QMARK","?")]
- 示例:
- 定义优先级:核心原则是找到表达式中优先级最低的符号优先处理(作为根节点)。
2. 具体执行流程
① 预处理(清理与替换)
- 提取并占位:把表达式中的字符串
'...'或"..."提取出来用占位符替换,防止内部字符干扰解析。- 示例:
range='0.1, 1, 0.1'$\rightarrow$range=__STR_CONST_0__
- 示例:
- 文本级转换:统一关键字(
or/and/not$\rightarrow$logical_or/...)、修复连号(--$\rightarrow$+)、规范化(NaN$\rightarrow$nan)。 - 移除注释(
/* ... */与行注释//或#)。 - 语句切分:按分号
;切分成多条语句,进入核心流水线:tokenize() $\rightarrow$ parse_expr() $\rightarrow$ to_python()。
② 自顶向下递归解析(Parse) 按照优先级从低到高进行检测:
- 赋值检测:去掉最外层分号;检查最外层(用括号记录层数)的赋值
=,剥离左右两侧。 - 三元检测:寻找最外层
?作为入口,向后扫描寻找同层级(depth=0)的:;每次遇到外层括号需剥去并重新检测。 - 二元检测 (BinOp):寻找最外层优先级最低的运算符。若优先级相同,则取最右侧的运算符拆分(左结合特性)。
- 一元与原子检测 (Atom):检查一元运算符(
!,-) $\rightarrow$ 单 Token 原子(数字, 字符串, 变量名) $\rightarrow$ 函数调用(逐个检查参数)。
③ 构建 AST 与代码还原
- 递归生成 Python 代码:对不同的 AST 节点对象分别调用处理逻辑。
- 还原占位符:每条语句生成 Python 片段后,将预处理时的“字符串常量占位符”替换回原字符串。
- 输出:收集所有处理过的语句,最终用
\n拼接并返回。
⚠️ 注意点:AST 解析一定要注意代码的覆盖率,保证在任何分支下都不会出现未定义的 token、operator 或异常的分支情况。
方案三:Parse 优化 (Pratt Parser)
token优化
把预处理步骤内化到token中统一处理.
⚠️ 避坑指南:Tokenizer 正则短路问题。 当把 DSL 转换为 Token 流时,如果使用正则表达式的命名分组(
(?P<NAME>...)),分组的声明顺序极其重要,因为正则引擎会执行短路匹配(匹配到第一个成功的组就立即返回截断):
- 错误示例:如果把操作符
OP([+\-*/]) 排在注释COMMENT(//.*) 前面,当代码出现// comment时,引擎会率先用OP规则抢走第一个/,再抢走第二个/。剩下的comment会被当作普通的NAME。最终导致 Pratt Parser 抛出类似Unexpected token in nud: OP /的灾难性错误。 - 正确做法:匹配范围更长、更具体的规则(如
//注释、==双等号)必须排在匹配范围更短、更宽泛的规则(如/单除号、=单等号)之前。
pratt优化
Pratt Parser 本质上是自顶向下递归下降解析器的一种优雅优化方式:它不是每次找最低优先级的字符,而是随着解析从左往右动态地构建 AST。
- 每个token除了优先级外, 定义两个方法: (nud和led)
- nud(null denotation, 前序) 当token出现在表达式开头时
- led(left denotation, 中序) 当 token 出现在 表达式中间(左边有东西)时调用
下面是一个DSL对应的token行为表格.
| Token/操作符 | 进入 nud / led | 触发条件 | 动作描述 |
|---|---|---|---|
| NUMBER | nud | token 类型是 "NUMBER" |
- 若全是数字 → Const(int)- 否则 → Const(float) |
| STRING | nud | token 类型是 "STRING" |
构造 Const(str),去掉引号 |
| NAME(变量) | nud | token 类型是 "NAME"且 peek不是 ( |
返回 Name |
| NAME (调用) | nud | token 类型是 "NAME" 且 peek=(函数调用 |
- 消费 ( → 解析参数列表- 参数支持关键字: key = value- 遇到 , 继续,否则结束- 消费 ) → 返回 Call(Name, args) |
| LPAREN | nud | 当前 token = (3 |
- 进入子表达式解析(rbp=-1000)- 必须遇到 ) 结束- 返回子树 |
| + / - (unary) | nud | token=OP 且值为 +/-,在前缀位置 |
以 get_prec("U+/-") 为 rbp 递归解析右操作数 → UnaryOp |
| ! (unary not) | nud | token=OP 且值为 ! |
以 get_prec("!") 为 rbp 递归解析右操作数 → UnaryOp("!", expr) |
| QMARK (?) | led | peek = QMARK 且 TERNARY_PREC > rbp |
- 消费 ?- 解析 true_part ( rbp=TERNARY_PREC)- 期望 :- 解析 false_part ( rbp=TERNARY_PREC)- 构造 Ternary(left, true, false) |
| 二元运算符 (如 + - * / ^ < > == != &&) |
led | peek 发现下一个 token 是操作符 (OP),并且该操作符的优先级 lbp > rbp 1 2 |
- 消费当前操作符(op) - 结合性处理: 如果操作符是左结合(默认情况),则 next_rbp = lbp; 如果操作符是右结合(如 =、^),则 next_rbp = lbp - 0.0001(轻微调整优先级, 为了遇到相同的运算符时继续解析) - 递归调用 parse_expression(next_rbp) 来解析右操作数(right) - 生成 BinOp(left, op, right) 节点 |
| LPAREN (函数调用) |
led | peek = (3 支持更一般化的函数调用. 比如, (a+b)(x)、foo()(x) 这种高阶调用 |
- 消费 ( → 解析参数列表- 参数使用 parse_expression(rbp=-1000)- , 分隔,直到遇到 )- 构造 Call(left, args) |
表格解释 $\downarrow$ :
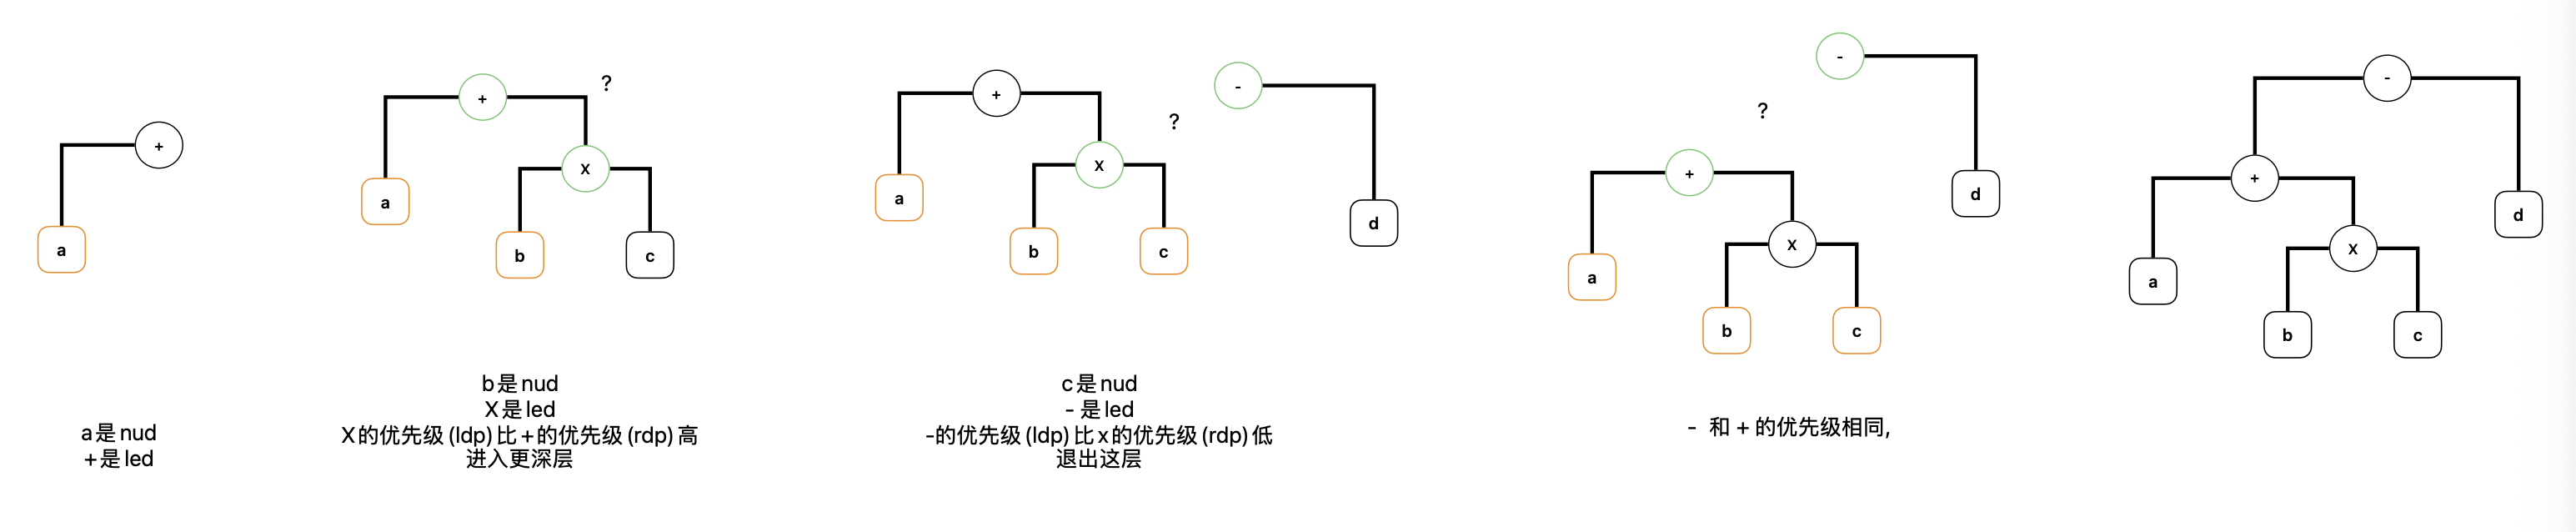
lbp(left binding precedence, 左操作数绑定优先级, 当前op的优先级),rbp(右操作符绑定优先级, 上一个op的优先级)- 当下一个op优先级更高时, ast会不断加深. 当下一个op优先级不足时, ast会从底向上直到找到合适的位置添加
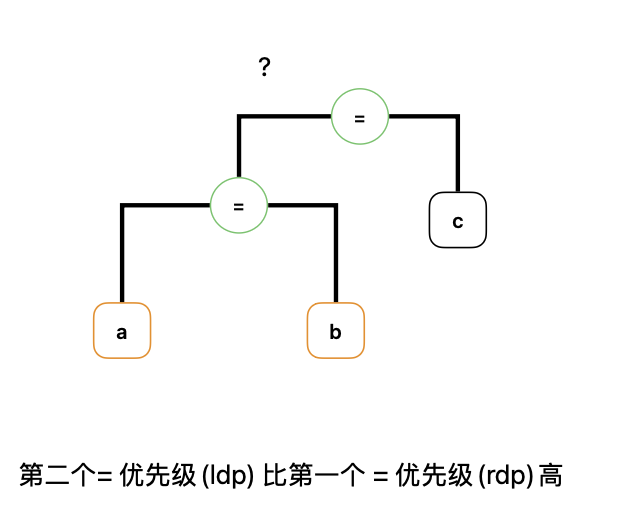
- 比如 a = b = c, 在第二个等号处, 把第一个等号的优先级稍稍降低, 保证右侧的优先级更高. 解析为 a = (b = c)
- 括号总是最优先的, 直接把rdp降到最低
a + b x c -d:
a = b = c: