面对一组只有输入输出的多维黑盒数据,如果我们确信其背后存在一个由人类专家设计的简洁内部公式,应该如何将其精准还原?
本文以破解 IS Score 评分为例,完整记录了我们如何借助 Agent 的力量,从海量数据统计起步,最终不仅实现了 100% 预测全中,还成功提取出了极具“物理美感”的底层解析式。
一、 核心方法论 (General Methodology)
在面对一个多维黑盒时,直接丢给神经网络或多项式拟合往往只能得到毫无意义的过拟合参数。通用且有效的逆向工程步骤如下:
- 探索性拟合 (Exploratory Fitting)
- 早期拟合的核心是“在多不在精”。应尽可能尝试多种影响因素作为分量,统计它们与目标值的相关性,尝试基础的线性拟合、Log 变换、Power Law (幂律) 等模型,以此圈定大致的解空间。
核心迭代循环 (The Core Iterative Loop)
在初步探索后,逆向工程绝不是一条直线,而是一个在以下几个步骤中不断循环、螺旋上升逼近真相的过程:
- 分离与控制变量 (Isolate & Control Components)
- 随着实验的推进,会不断有变量的作用被部分甚至完全确定。一旦验证了某一部分结构是完全正确的,就应该尝试锁定其参数,将其作为常数项提出来进行降维。固定已知、剥离相对确定的变量后,我们才能对剩余的未知维度进行更高精度的探索。
- 残差与异常值分析 (Outlier Analysis)
- 在每剥离或固定一层规律后,必须将分析重心转向此时残差极大的 Outlier(异常点)。
- 将异常点的关键标签拆解出来,在原图上进行标记和验证。这一步的根本目的是定位并验证产生异常的底层原因,从而寻找目前拟合公式存在的漏洞。
- 切片与分段 (Slicing & Segmentation)
- 观察数据分布,寻找分界点。如果发现不同数据区间表现出截然不同的斜率或规律,就应该将其拆开分段处理(而不是强求用一个复杂的连续方程拟合全部数据)。分段在实战中有两种完全不同的场景与目的:
- 还原真实阈值:底层业务逻辑本身就存在硬性的阈值开关,分段是为了真实还原这些逻辑。
- 降维控制变量:纯粹作为把复杂问题拆解的战术手段。即使我们明知整体可能是一个连续函数,但在探索中途还不知道某些变量的精确形态时,可以通过窄区间的分段切片来锁定这些未知维度的影响,从而为解析已知维度创造干净的环境。此外,强烈建议在数据中寻找那些“天然控制变量”的数据切片(例如某个维度恰好为 0),这些极端的切片能直接消除该变量带来的不确定性,提供极其纯粹、精准的信息,极大加速拟合与推导过程。
- 观察数据分布,寻找分界点。如果发现不同数据区间表现出截然不同的斜率或规律,就应该将其拆开分段处理(而不是强求用一个复杂的连续方程拟合全部数据)。分段在实战中有两种完全不同的场景与目的:
- 多项式探路与形态猜测 (Polynomial Probing & Shape Guessing)
- 当成功剥离出某个未知的单变量函数时,不要急于用复杂的公式盲猜。最稳妥的方法是先用高阶多项式进行纯数学拟合,并将离散的散点画成连续的曲线图。通过观察多项式曲线的几何形态,再对照常见的函数库去猜测它更简单、更具物理意义的解析式表达。
- 规律融合 (Fusion)
- 随着模型精度的提高,如果我们在对不同切片进行分析时,发现它们背后其实受同一种更高维度的数学规律支配(例如曾经被割裂的两段折线,其实是同一个连续的对数或指数函数在不同区间的表现),此时就应该大胆尝试将这些分段重新融合为一个统一的方程。融合能极大地提升模型的泛化能力。
终极收敛 (The Ultimate Convergence)
- 模型泛化与次优化 (Sub-optimization & Physical Elegance)
- 机器跑出来的初始高精模型往往充满了“过拟合”的丑陋痕迹,我们需要在确保精度的同时,向着“物理美感”进行次优化:
- 优化变量组合 (公式化简):在得到初步的复杂关联后,尝试对其进行代数化简与收敛。如果化简后模型依然能解释绝大部分方差,说明我们找对了核心特征。
- 优化系数 (强制向人类偏好收敛):工程系统是由人类设计的,人类天然偏好简洁、整数、干净的分数或特定行业的物理常数。将机器拟合出的“丑陋小数”强制约束为有意义的整数或常数倍数。如果约束后残差没有显著增大,甚至完全消失(错误抵消被消除),那就说明我们真正触及了底层的设计灵魂。
二、 实战演进:IS Score公式逆向纪实
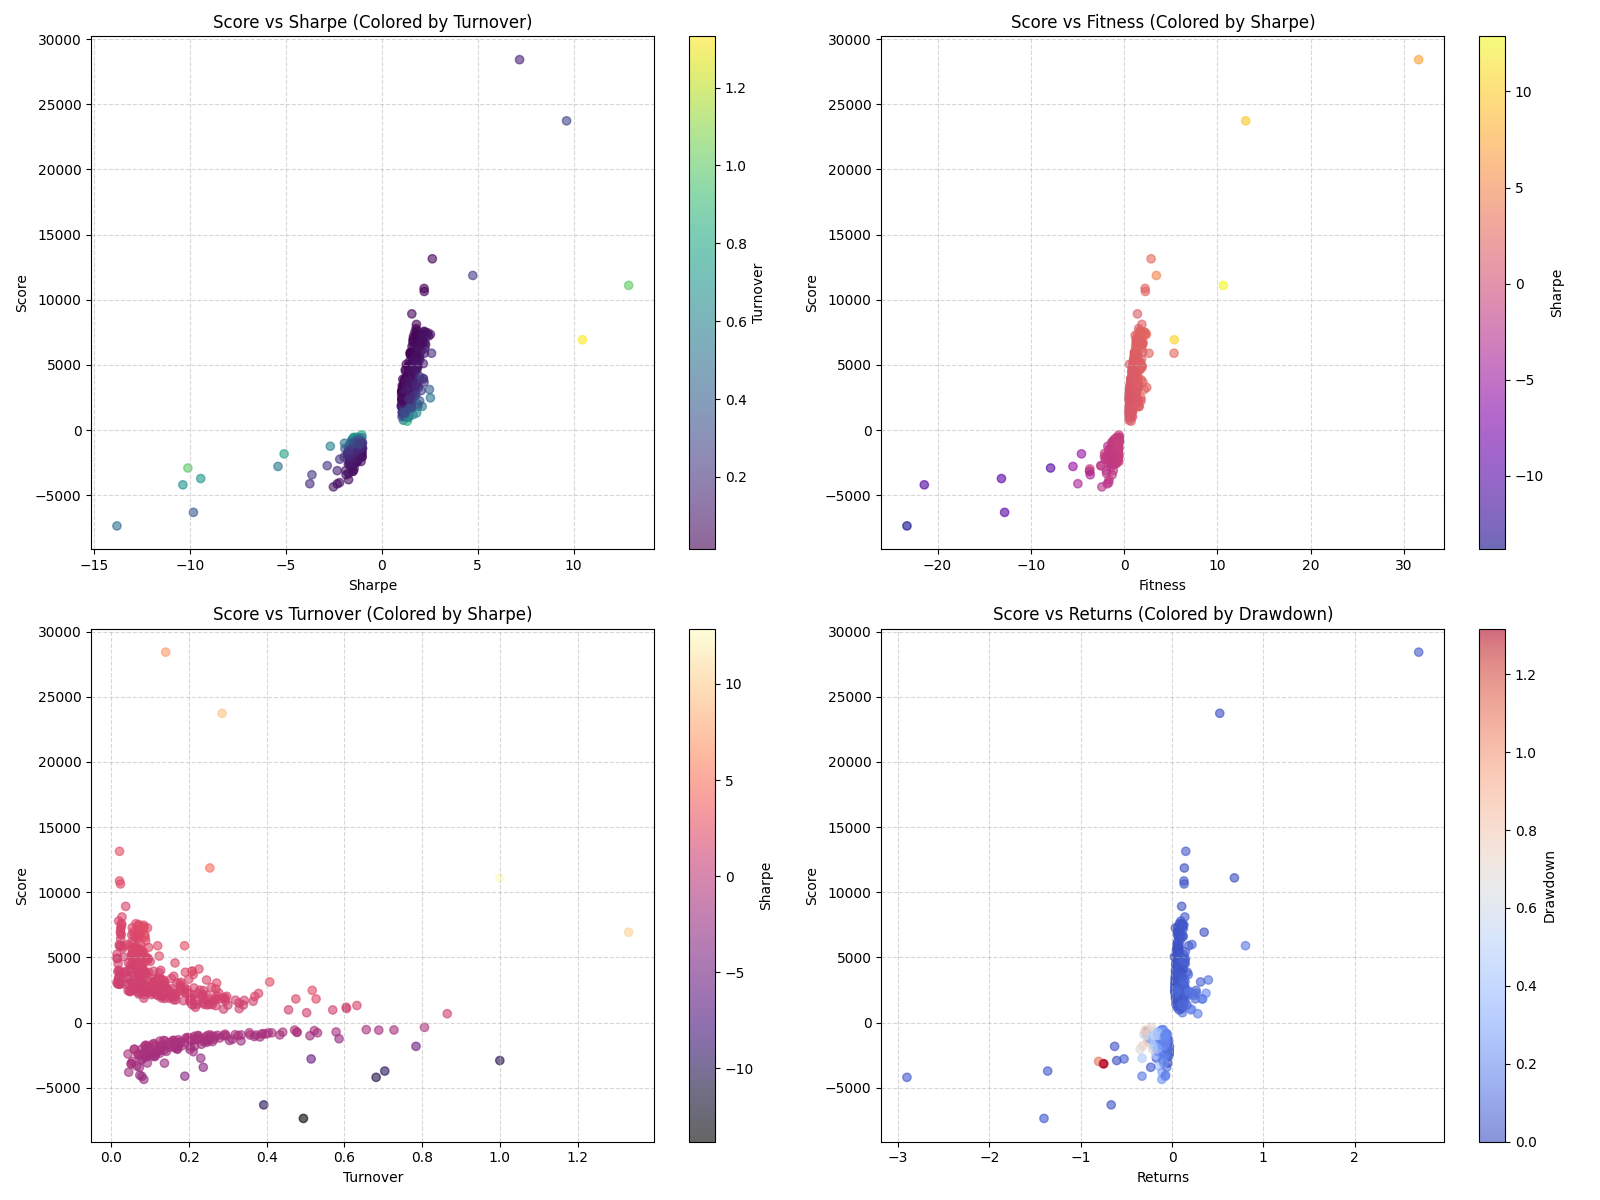
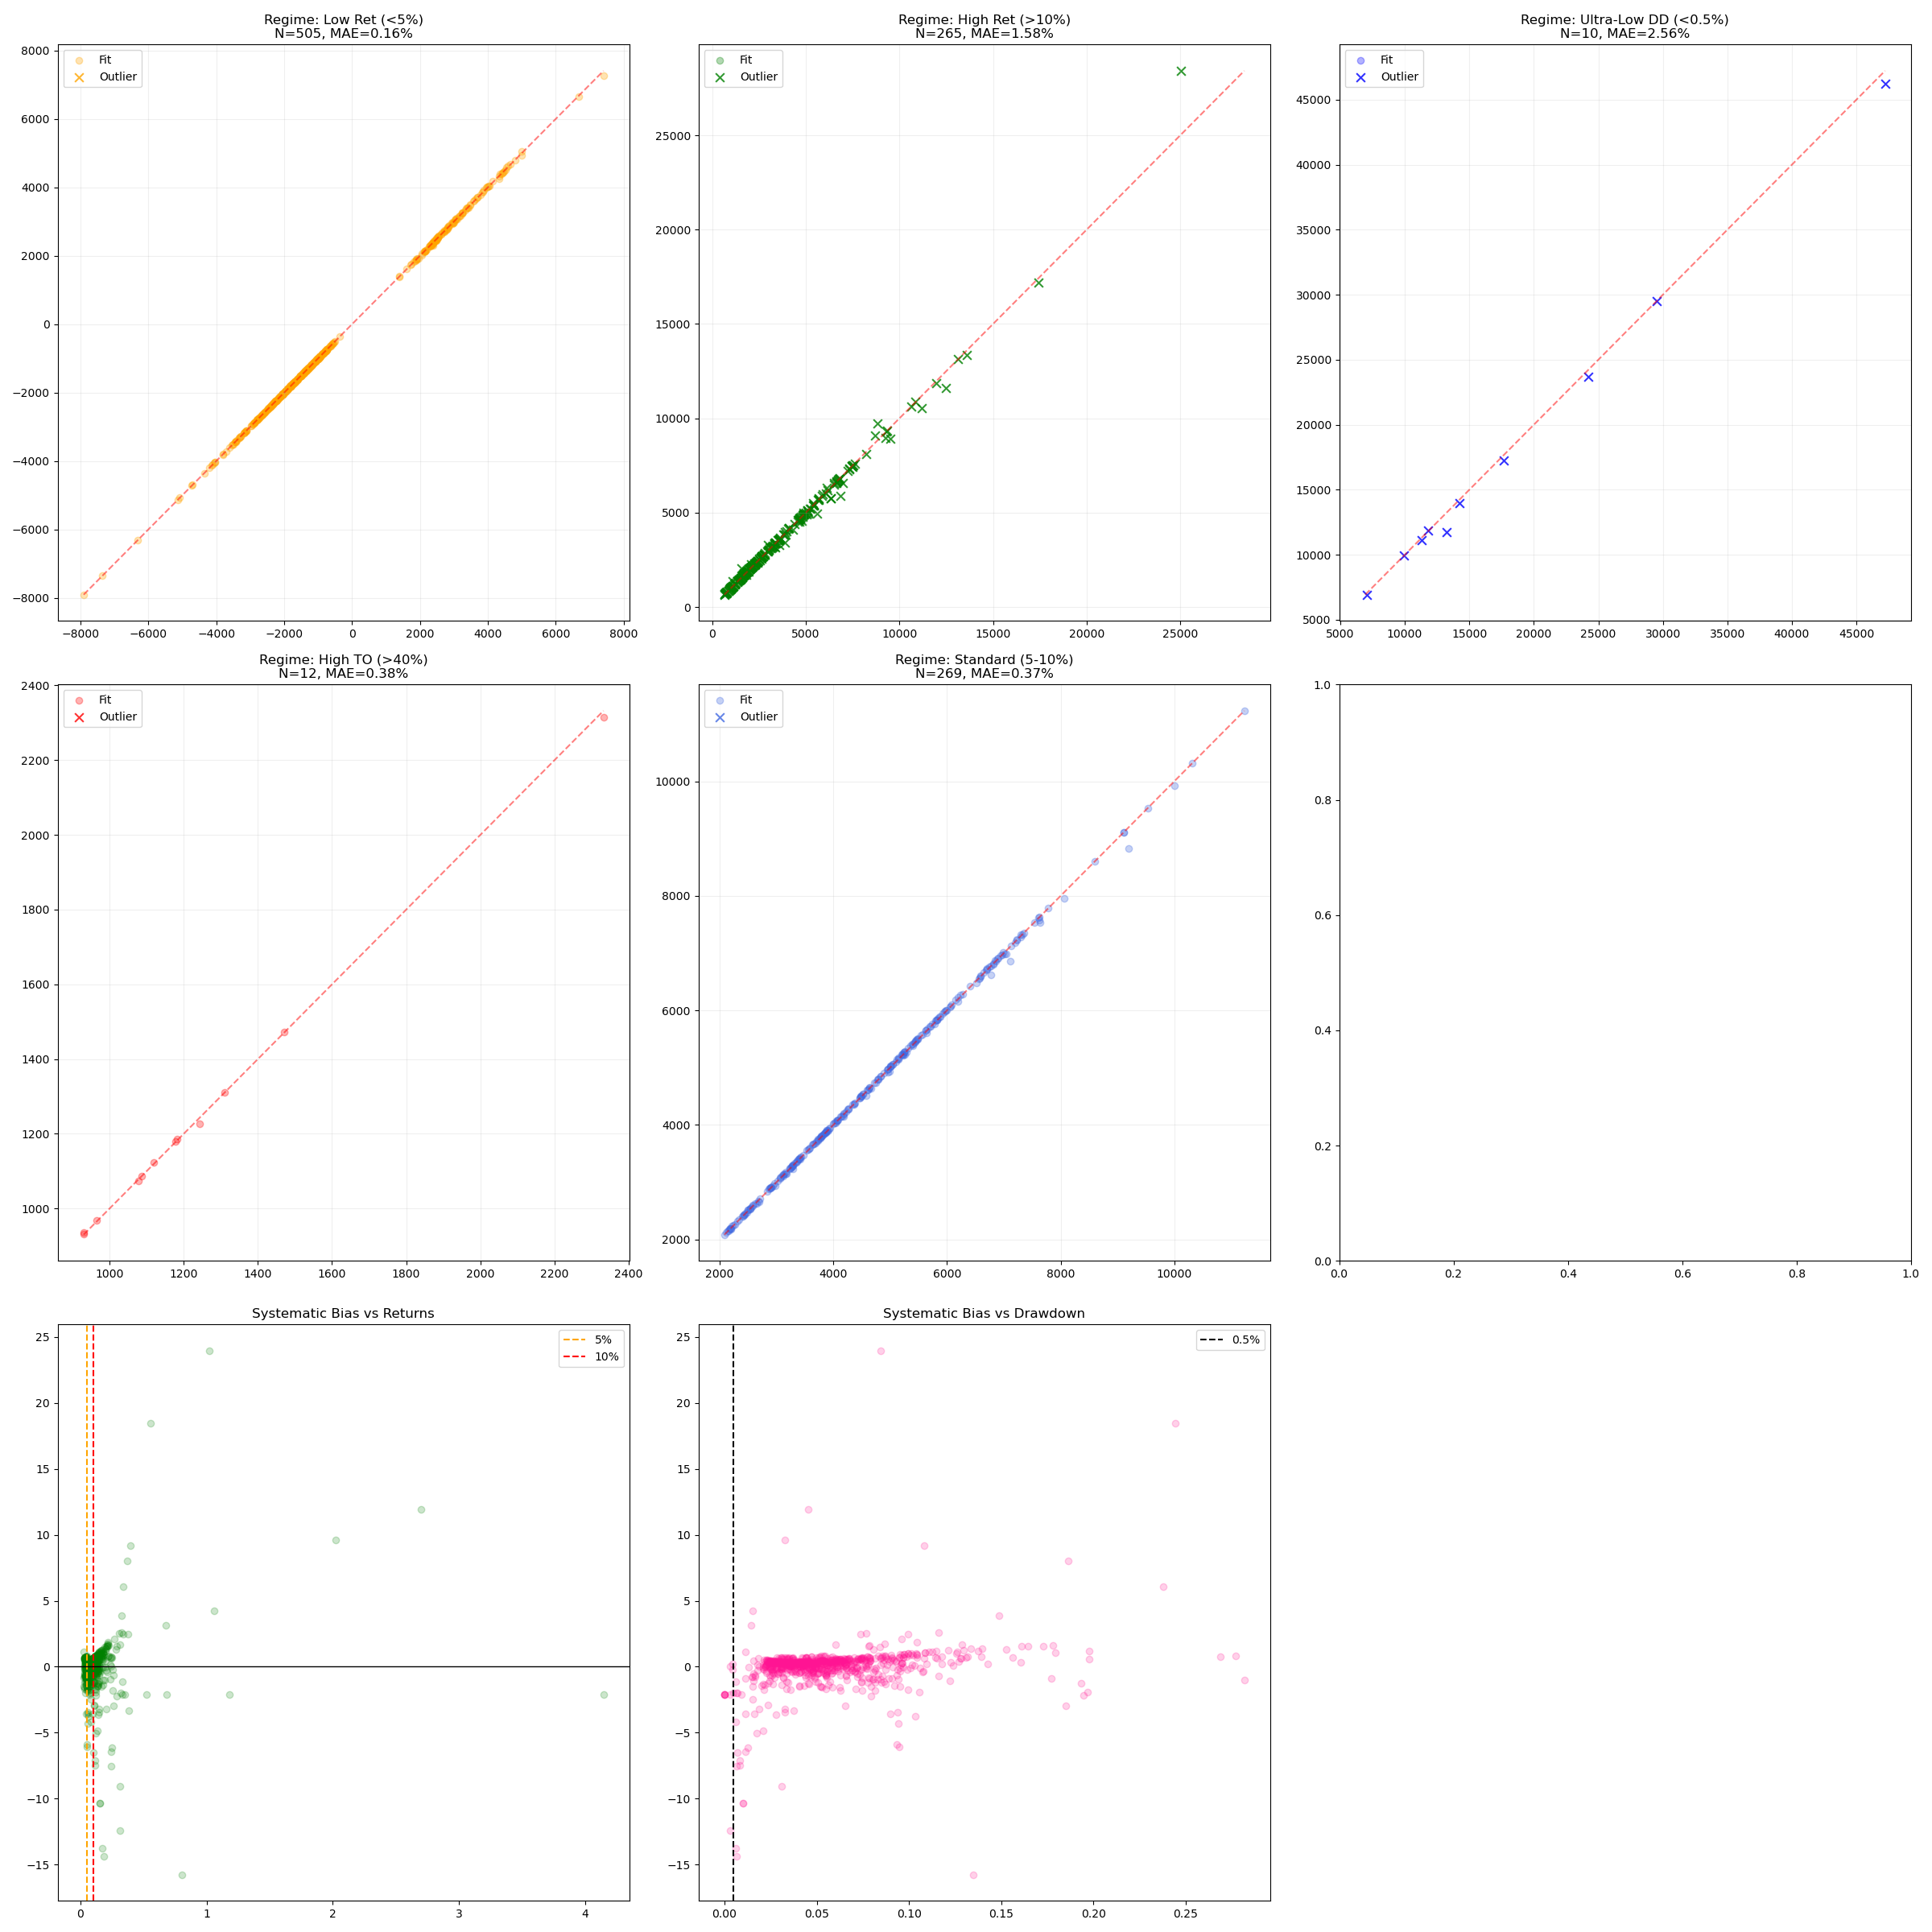
在实际破解 IS Score 评分的过程中,我们的推进严格遵循了上述方法论,以下是突破公式的全部关键节点:
- 确定基本线性结构:首先分析出 Sharpe 和 Turnover 的参数是 1。
- 正负域分离:发现正负分数的计算逻辑不对称,分析出正负应该分段处理。
- 定位换手底噪:针对低换手率的异常高估,分析出 Turnover 有个固定的 Offset (即 $Turnover + 0.1$)。
- 收益与回撤的耦合:
- 发现 Returns 和 Drawdown 总是呈现出共用指数的特性。
- 进一步分析出 Returns 和 Drawdown 是深度耦合在一起的。
- Calmar 比率的截断与降维:
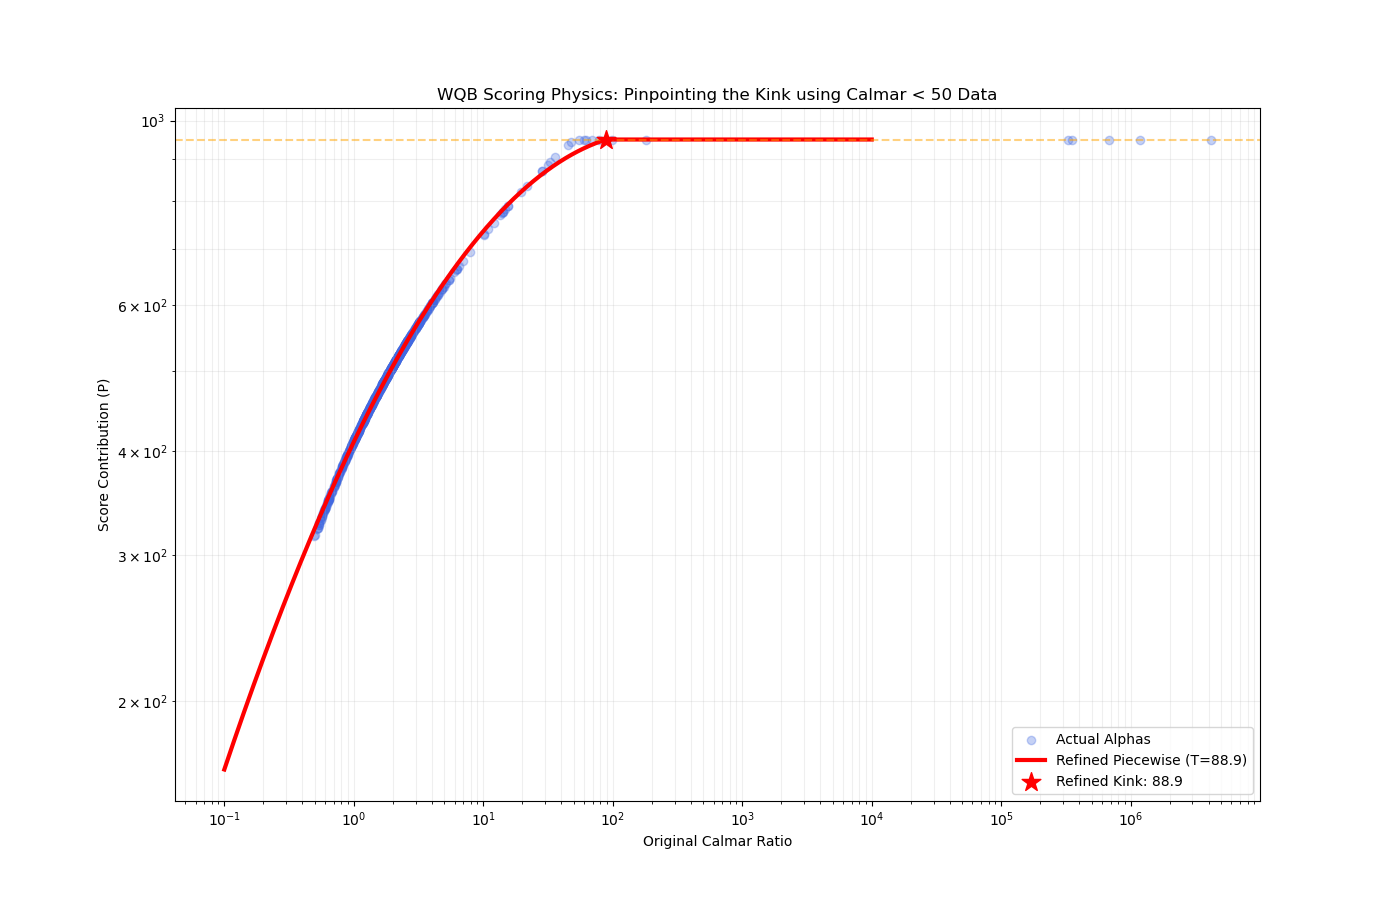
- 锁定这部分耦合后,分析出它们构成了 Calmar 比率 ($Returns / Drawdown$),且系统对高 Calmar 比率是有强行截断的。
- 分析出 Calmar 比率在上升期存在一个明显的曲线衰减变换(边际效用递减)。
- 为此我们遍历了 Log、Michaelis-Menten 饱和函数、Power law 等多种函数形态,在取得初步进展后,最终锁定了反双曲正弦函数 (
arcsinh) 形态。
- 终极微调与物理收敛:
- 在去掉所有完全正确的已知参数(如 Sharpe / (Turnover + 0.1))后,对剩下的、在更简易模型上的残差进行微调参数。
- 经过次优化与常数强约束,最终发现了完美吻合的
arcsinh与200*Calmar^2的物理方程。
最终,我们得到了零误差(全量预测完美吻合)、且充满物理设计美感的终极解析式: $Score = C_{curve} \times P(Calmar) \times \frac{Sharpe + 0.0001}{Turnover + 0.10}$, $P(Calmar) = 0.34108 \times \text{arcsinh}(200.0 \cdot Calmar^{2})$
三. agent的帮助
虽然agent可以快速写代码验证, 但是agent就是我在生活中遇见的所有蠢人合订本, 需要花特别大的力气和它对抗:
武断:基于不充分信息,构造看似合理但站不住脚的前提
冒进:试图“一步到位”,跳过最小验证
偏见: 用个例支撑结论,把偶然当规律
逃避:方案失败,不复盘路径,直接否定问题
盲试:没有假设结构的尝试, 不停换方法
偷换:把“感觉可行”当成“已经可行”
浮夸:用语言强度掩盖方法粗糙