hash映射
估算alpha id 和什么有关
代码语法解析
三元运算符(ternary)解析
选出最佳的表达式组合
从给定的100个左右operator, 和10多个参数, 结合生成表达式
拉格朗日乘子法应用 (一 )
拉格朗日乘子法(Lagrange multiplier )一般问题
选出最佳的因子组合
遗传算法(Genetic Algorithm): 1. generate a bunch of solutions 2. 算子:选择算子(selection): Roulette Wheel Selection(轮盘赌): 1. 适应性越强概率越大,随机选择父母 2. Use accumulation of probability and bisect e.g. probability [0.25,0.25,0.5], accumulation [0.25,0.5,1], when using bisect —0—0.25—1—0.5—2—[prabablility bigger->interval of accumulation is bigger-> has more chance to be choosen] Tournament Selection(锦标赛):1. random choose n 个个体,选出其中最好的 Linear(Exp) Ranking Selection: 排序,按照顺序线性(exp)确定probablility 交叉算子:uniform crossover: 变换father和mother的一些位 中间重组(浮点数):取father和mother的随机中间数 变异算子:flipbit: 异或(二进制),随机替换(实数) 3. 编码二进制:range=(a,b), eps = 精度 ->int((x-b)/eps)转为二进制(编码位数: log((b-a)/eps) ) !4. 遗产算法的编码非常重要?:要保证交叉算子起作用,即亲代可以强强联合,不然就和变异算子没有差别了
聚类
距离
传感器颜色调制 (四) – 多光谱颜色校准
用RGB校准多光谱数据
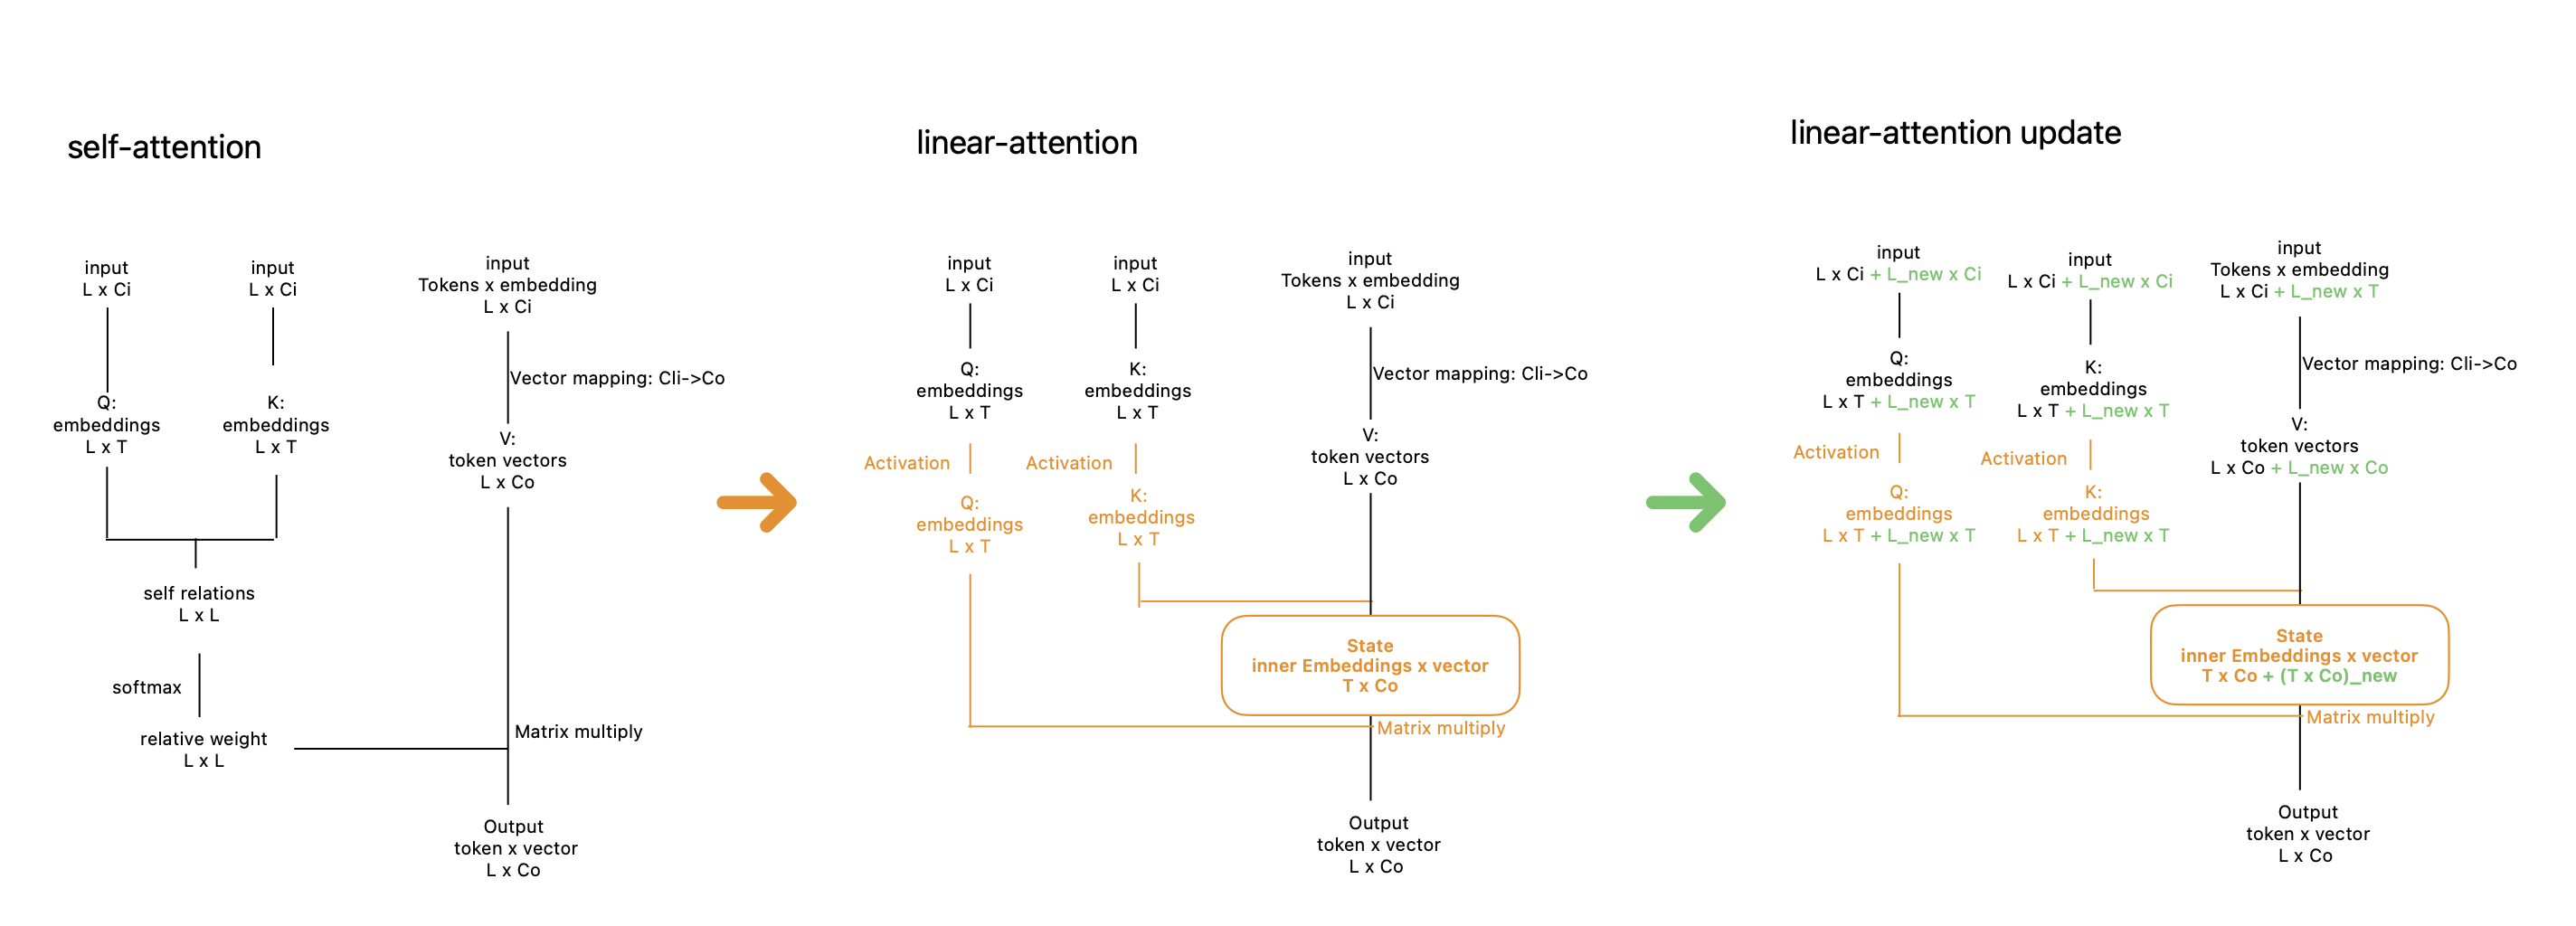
attention的优化– KV Cache
摄像头测距
- 问题定义: 从摄像头组拍摄的画面中得到汽车的3维bounding box
persistent homology 事例 + 应用
pair graph
conformal geometry学习 (八 ) – Persistent homology
一种计算 $H_k(\Sigma,\mathbb Z_2)$ 的方法, 计算filtration $\mathbb K$ 中homology的变化
conformal geometry学习 (一 ) – fundamental group
fundamental group分类曲面是足够精细的
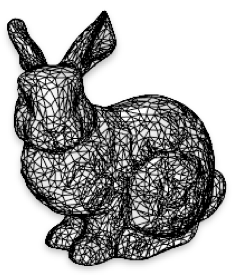
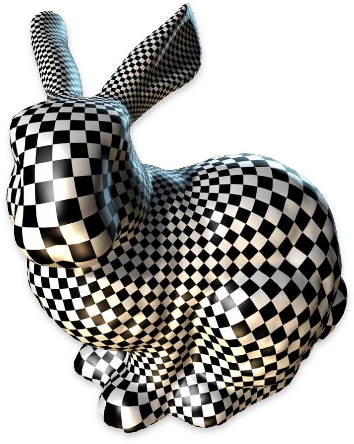
四边形网格生成
 ->
FFT计算
- fourier Series 定义:
- $F(f)(u)=\int_{-\infty}^{\infty} f(x)e^{-2\pi i x u} dx$
- 2维:$G(p,q)=F(g(x,y)) = \int\int^\infty_\infty g(x,y)e^{-i2\pi(px+qy)}dxdy$
- 2维的可以拆分成1维
- 离散形式: 信号$x$ 的FFT 信号$X$
- $X_k=\sum_{m=0}^{N-1}x_m\cdot e^{-i\cdot 2\pi km/N}=\sum_{m=0}^{N-1}x_m\cdot TW(N,k)^m$
- $N$ 是信号长度
- $k$ 是sample的位置
- $TW(N,k) = e^{-i*2k\pi/N}$ 是FFT 的twiddle factor(旋转因子)
- $TW(N,k)=\cos(-2k\pi/N)+i\cdot \sin(-2k\pi/N)=TW_r(N,k)+i\cdot TW_i(N,k)$
- $X_k=\sum_{m=0}^{N-1}x_m\cdot e^{-i\cdot 2\pi km/N}=\sum_{m=0}^{N-1}x_m\cdot TW(N,k)^m$
各种 moving function
场景
moving mean
小面积光流传感器算法测试 (三) – 滤波
在高速场景下, 每次中断收集的数据是光流的累加值, 其实本来就相当于一个滤波…况且在硬件有限的条件下, 复杂的滤波没有什么实用价值.
小面积光流传感器算法测试 (二) – 特征训练
数据
Diffusion Process 和 Reverse Diffusion Process理解
背景知识
Bayes’ rule
小面积光流传感器算法测试 (一)
大概分为: preprocess -> instant flow compute -> filter correct 三个步骤
attention的优化– flash attention加速
flash-attention是一种算子合并(kernel fusion)的优化. 把self-attention分块, 直接在SRAM里计算, 省去了HBM来回搬运中间结果S和P的时间(如下图). self-attention由两层矩阵乘法, softmax, 和其他eltwise计算(mask, dropout)构成.